21-内存、分配器、崩溃与可靠性:从一次 OOM 到可行动的证据链
俊宁 · 日期未详文章目录
从源码阅读入口、进程边界与验证条件理解内存、分配器、崩溃与可靠性:从一次 OOM 到可行动的证据链。
本文讨论通用机制和设计判断;示意不对应任何具体产品的已交付状态。源码阅读坐标沿用原稿,本次整理不构成新的运行时验收。
阅读坐标沿用原稿:Chromium
153.0.8010.37,上游 commitb75a5a95ea1a1b55bdbfd6d9f42d47be7507fb8b。本次同步未重新进行源码与目标平台运行时验收。
一句话结论
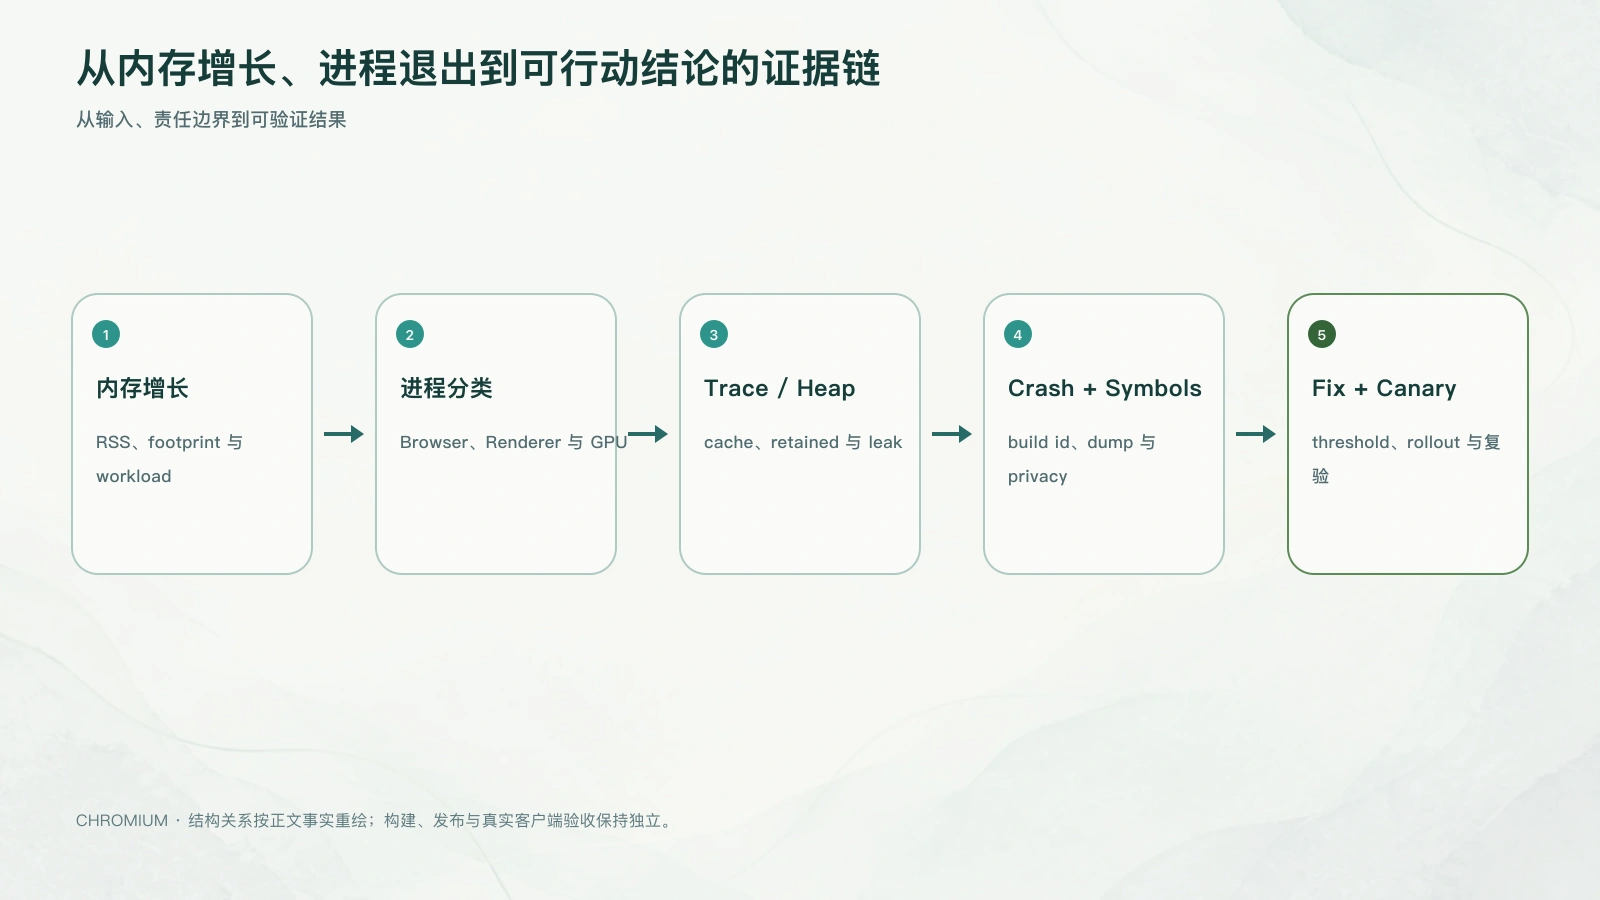
可靠性不是一个 crash rate:要先区分进程、内存域和退出原因,再把现场保全、符号匹配、隐私合规、版本聚合、止损和修复回归串成可追踪路径,才能把一次“页面没了”变成可行动结论。
稳定性不是“尽量少 crash”的单一指标。浏览器有多个进程、多个内存域和多种退出原因:Renderer 被杀、GPU reset、OOM、watchdog、显式崩溃、系统回收、正常关闭都可能在用户侧表现为“页面没了”。可靠性工程要将 预防、隔离、检测、归因、止损和修复验证 连成链,而不是只收集一堆 dump。
PartitionAlloc:分配器是性能与安全边界的一部分
Chromium 使用 PartitionAlloc 及其 shim/support 作为重要内存分配基础设施。base/allocator/partition_allocator/src/partition_alloc/ 包含 partition root/bucket、thread cache、freelist、address space、reclaimer、hardening、raw pointer 支持与 OOM 路径;base/allocator/partition_alloc_support.* 把它接入更高层配置。
阅读时不必从 bucket 算法开始,而要先知道它解决的类别:隔离/分区、复用与缓存、地址空间管理、内存回收、悬垂指针缓解与诊断。它并不保证没有 OOM、没有逻辑 leak、没有数据 race,更不允许业务代码绕过生命周期和 sequence contract。
| 问题 | 分配器可能帮助 | 仍需其他机制 |
|---|---|---|
| use-after-free 类内存错误 | hardening、隔离、指针保护/检测 | 正确 ownership、WeakPtr/refcount、测试和审计 |
| 高频分配性能 | thread cache、bucket/partition 策略 | workload、GC/对象生命周期、主线程任务设计 |
| 内存压力 | reclaimer、统计与 OOM path | 产品降级、tab discard、资源预算、用户可见恢复 |
| crash 归因 | 更早发现某类损坏 | 符号、版本、复现、最小根因与修复验证 |
因此不要为了一个业务模块“优化内存”直接改 allocator flag 或全局分配行为。先用 trace、heap/profile、进程 RSS、对象生命周期和重复 workload 证明问题位于何处;全局 allocator 变化要按 Kernel 风险处理,并在所有目标 Distribution/平台验证。
OOM 与进程退出:用户看到的是症状,不是原因
PartitionAlloc 的 oom.*/oom_callback.* 与浏览器各进程的内存压力处理是底层路径的一部分。OOM 可能来自单个 Renderer、GPU、Browser、地址空间限制、资源泄漏或系统整体压力。杀掉一个 Renderer 是多进程隔离的止损能力,但用户体验上仍可能是页面崩溃、表单丢失或任务失败。
memory growth / allocation failure / system pressure
  -> process-local handling or OOM termination
     -> Browser observes child exit / tab state changes
        -> user-visible recovery, reload, restore or error UI
           -> crash/metrics/trace evidence for aggregation
              -> reproduction, mitigation and verified fix
排查时必须记录 process type、pid/instance、版本、平台、memory footprint、最后用户动作、是否有 GPU/Renderer crash、是否复现以及 Browser 如何恢复。仅凭“进程退出码”无法区分坏网页、扩展 leak、媒体/GPU 压力、内核 patch、驱动和系统回收。
Crash reporting:收集、符号化、上传与可行动性是四件事
components/crash/、crash keys 与 third_party/crashpad/ 体现 crash pipeline 的组成;不同平台有各自 handler/系统报告入口。Crash report 只有在满足以下链路时才有工程价值:
| 状态 | 最小证据 | 不等价于 |
|---|---|---|
| crash 已捕获 | 本地 dump/handler 记录 | 已能定位源码行 |
| 已符号化 | 与二进制严格匹配的 symbols/build id | 根因已经明确 |
| 已上传/聚合 | 合法 endpoint、版本/渠道与去重维度 | 数据可安全使用或已修复 |
| 已行动 | 有可复现假设、owner、修复与回归证据 | 所有相关 crash 已消失 |
Crash key 应帮助聚合,不应塞入 URL query、token、页面正文、文件路径、用户 prompt 或私密 Agent 输出。符号包、dSYM/PDB、最终 artifact hash 与版本映射是 release 交付物的一部分;本地 debug build 能显示栈,不证明线上 signed binary 可以正确符号化。
从指标到止损:可靠性要进入发布验收
测试、trace、日志和 metrics 分别支撑不同强度的结论;在稳定性问题上还要加两个边界:canary/分渠道观察 与 停止推广/forward fix。Chromium/Extension/Runtime 出现高影响 crash 时,正确动作不总是“回滚一个包”:更新是否支持降级、数据格式是否可逆、不同 Distribution feed 是否独立,都会决定可用手段。
| 阶段 | 需要的可靠性动作 |
|---|---|
| 开发 | sanitizer/单测/browser test、内存与生命周期 review、稳定复现 |
| Build | 保存精确 base、GN args、symbols、artifact hash 与待签名制品信息 |
| canary | 定义 crash/退出/关键流程失败阈值、版本/渠道/平台分桶与止损 owner |
| Release | 签名、artifact 回读与 feed/channel 激活;不替代旧客户端升级 |
| Client Update | 旧客户端升级、监控与告警生效,按渠道决定停止推广或 forward fix |
| 事故 | 停止推广、保全证据、按可逆性选择 rollback 或 forward fix、补回归测试 |
工程推演:内存上涨不等于内存泄漏
一次操作后 RSS 上升,可能是对象仍被业务引用、allocator/thread cache 尚未归还、Blink/V8/媒体缓存保留、GPU resource 增长、mapped file、正常峰值,或真正的不可达对象泄漏。直接比较任务前后两个 RSS 数字,无法区分这些原因;更不能跨不同进程、不同 workload 或不同采样工具计算“优化百分比”。
建议把判断拆成四步:先固定页面、Profile、feature、设备和动作次数;再按 Browser/Renderer/GPU/Utility 分进程观察 private footprint 与相关细分指标;随后增加 idle/GC/navigation/Tab close 等生命周期节点,观察资源是否按契约回落;最后才用 heap/profile、allocation trace、对象计数或 dump 将增长归因到具体 owner。
| 观察到的形态 | 优先假设 | 下一份证据 |
|---|---|---|
| 首次上升后平台期 | 初始化或有界缓存 | 重复 workload、idle 后状态、cache 统计 |
| 每轮近似线性上升 | retained object 或资源未释放 | heap diff、owner graph、close/navigation 回收 |
| Renderer 独占增长 | 页面/Blink/V8/Extension 注入 | frame/document、heap、任务与 GC 时间线 |
| GPU 增长伴随 context 问题 | texture/surface/driver 路径 | GPU trace、resource lifetime、context loss |
| Browser 全局增长 | Profile/service/cache/全局 observer | 多 Profile、shutdown、service owner 与 dump |
Crash 也需要同样的分类纪律:dump 已生成、symbols 能匹配、事件已上传、后台已聚合、根因已定位、修复已覆盖并发布,是六个不同状态。缺少 build id/artifact hash 的漂亮调用栈,往往比一份未符号化但可精确关联版本的 dump 更危险,因为它会制造错误确定性。
先把“内存”拆成可解释指标
RSS、private bytes、Physical Footprint、allocator committed/resident、JS heap、GPU memory 和磁盘 cache 表达不同资源。多进程还会共享 code page、共享内存和映射文件,简单相加 RSS 可能重复计算;只看 Renderer JS heap 又会遗漏 Blink object、Skia/GPU resource 和 Browser cache。
报告必须写明平台指标定义、进程集合、聚合方式、workload、采样窗口与 build。macOS 可以完整进程树 Physical Footprint 为主、RSS 辅助拆分;Windows 使用对应 commit/private working set 等指标时也要保持前后一致。不同指标不能计算“下降百分比”。
增长、缓存与泄漏需要时间行为区分
一次峰值后回落、达到平台后稳定、随用户对象数线性增长、关闭场景后不释放,代表不同假设。缓存可能在内存压力下才清理,allocator 释放对象后也未必立即归还 OS;因此“页面关闭后 RSS 没回初始值”不足以证明 leak。
更有效的实验是重复固定动作 N 次,标记每轮开始/结束和 GC/pressure,观察 retained object、committed/resident 与进程级趋势。对照关闭 Tab、清理业务对象、触发适当 memory pressure 后的变化,再用 heap/profile 识别 owner。
PartitionAlloc 既是性能组件也是安全边界
PartitionAlloc 管理多类分配、bucket、thread cache、quarantine/安全机制与进程内统计。调优某个阈值可能影响碎片、峰值、吞吐与 exploit mitigation,不能把 allocator switch 当成普通业务参数。
排查 native memory 应先按 process 和 subsystem 分类,再用 allocator/heap profiler、trace 与代码 ownership 收敛。全局替换 allocator 或关闭安全特性来验证性能,只能用于受控诊断,不能直接成为产品方案。
OOM 可能由系统、进程限制或提交失败触发
用户看到 Tab crash、Browser exit 或系统卡顿时,根因可能是单 Renderer 膨胀、完整进程树压力、GPU/共享资源、address space/commit、系统 memory pressure 或平台终止策略。Crash reason 与系统日志要对齐,不能把所有无 dump 退出都记成 OOM。
止损策略也应匹配 owner:限制页面/任务并发、释放 cache、隔离高风险工作台、重启可恢复 service、降级大上下文,分别解决不同问题。粗暴提高 V8 heap 上限可能延后 JS OOM,却推高系统总压力。
Crash dump 到可行动 stack 需要完整供应链
Dump 收集后必须关联 product/version/channel/process type、build id 和准确 symbols;符号化失败、版本不匹配或隐私过滤都会让 stack 不可靠。聚合时还要结合 exception、top frames、process uptime、feature/config 与 breadcrumb,避免把不同根因按一个表面函数合并。
上传成功只证明对象到达服务,不证明已符号化、已聚合或有人能行动。release gate 应验证目标 artifact 对应 symbols 已保存、抽样 dump 可符号化、敏感数据符合规范、告警和回退 owner 明确。
修复后的可靠性验收
本地稳定运行和压力测试是必要证据,但真实发布还要按版本/channel 观察 crash rate、OOM、memory trend、restart/recovery 和用户关键任务。指标改善同时要看性能与功能是否回退,例如更积极杀 Renderer 可能降低 Browser OOM,却增加用户工作丢失。
Canary/灰度需要预设阈值、观察窗口、停止与回退条件;不能发布后再挑一个有利指标解释。修复完成的标准是目标客户端获得新版本,在相同 workload 下风险下降且没有把失败转移到另一进程或恢复链。
工程结论
可靠性治理的目标不是“收集更多崩溃”,而是缩短从症状到 owner、从 owner 到止损、从修复到真实客户端验证的时间。任何全局 allocator 或 crash pipeline 变更都影响所有 Distribution,必须以可比较 workload 和分渠道证据做决策。
继续阅读
- 20-网络传输、安全连接与代理:一次 URL 请求如何真正到达对端: 相邻章节的前置机制。
上游源码入口
文中的相对源码路径可从 Chromium 官方上游快照 定位。此入口保留原稿的上游阅读坐标,不包含任何产品定制代码,也不替代运行时验收。