端侧模型推理生态:ONNX Runtime、llama.cpp、MLX、Ollama 与 LM Studio 怎么选
俊宁 · 日期未详文章目录
按模型、制品、运行时、本地服务和应用集成分层,比较 ONNX Runtime、llama.cpp、MLX、Ollama 与 LM Studio 的适用边界。
本文讨论通用机制和设计判断;示意不对应任何具体产品的已交付状态。源码阅读坐标沿用原稿,本次整理不构成新的运行时验收。
端侧模型集成常把模型、制品格式、推理运行时和本地服务混在一起。先把这些对象放回各自层级,再判断它们是竞品还是上下游。
一句话总结
ONNX、ONNX Runtime、llama.cpp、MLX、Ollama、LM Studio 并不是六个同类产品:模型、制品格式、推理运行时、本地服务和应用集成是五层不同问题。
更直白地说:
- Qwen、Llama、Gemma 是具体模型家族,决定“模型会什么”。
- ONNX、GGUF、MLX 权重是模型制品形态,决定“模型以什么格式交付”。
- ONNX Runtime、llama.cpp、MLX / MLX-LM 才接近“发动机”,负责真正执行推理。
- Ollama 更像带模型下载、版本管理、进程管理和 HTTP API 的本地模型服务。
- LM Studio 是带图形界面、模型管理、推理 Runtime 和本地 API 的桌面工作台。
- 应用 Runtime 或桌面应用位于最上层,决定选择哪条路径、怎样降级,以及谁承担交付责任。
因此,它们既可能竞争,也可能配合:ONNX Runtime、llama.cpp 和 MLX 在部分推理场景中互为替代;Ollama 与 LM Studio 处在同一产品层,更接近直接竞品;两者又可以使用 llama.cpp 等底层推理引擎,LM Studio 在 Apple Silicon 上还可以使用 MLX。一个真实产品同时使用 ONNX Runtime,并把 Ollama 和 LM Studio 作为两个可选 Provider,是合理的架构。
这次调研还修正了三个容易过度概括的判断:
- ONNX Runtime 的 Node 预编译包确实覆盖 Windows、macOS 和 Linux,但默认可用的硬件加速并不相同。CPU 路径覆盖最广,DirectML、CUDA 等 Execution Provider 有各自的平台矩阵;“跨平台 API”不等于“各平台同样加速”。
- MLX 仍以 Apple Silicon 为核心设计目标,但当前官方仓库已经提供 Linux CPU / CUDA 安装路径。因此准确说法是“Apple Silicon 优先”,不是“只支持 macOS”;Windows 仍不是它的主路径。
- Transformers.js 在 Node 中默认会把首次下载的模型缓存到依赖包目录,并允许访问远程模型。对普通 Node 应用这很方便,对可更新、可签名的 Browser Distribution 却不够显式:缓存目录、是否允许远程下载、模型来源和冷启动并发都必须由产品接管。
先把生态拆成五层
(此版本省略该配图。)
端侧推理只说明“计算主要发生在用户设备”,没有说明模型是什么、由谁加载、跑在哪个进程、是否需要本地服务,也没有说明模型文件由产品随包交付还是由用户自行安装。
把这些概念放回五层,竞品关系就清楚了。
| 层级 | 回答的问题 | 典型对象 | 主要竞品关系 |
|---|---|---|---|
| 模型家族 | 模型具备什么能力 | Qwen、Llama、Gemma、Phi | 模型与模型竞争 |
| 模型制品 | 权重和计算图如何交付 | ONNX、GGUF、MLX 权重 | 格式与转换路线竞争,但能力不必然等价 |
| 推理运行时 | 谁真正执行计算 | ONNX Runtime、llama.cpp、MLX / MLX-LM | 局部竞争,任务和平台侧重点不同 |
| 本地服务 | 谁管理模型并暴露 API | Ollama、LM Studio、自建 server | 本地服务产品直接竞争 |
| 应用集成 | 谁编排能力和承担用户体验 | 应用 Runtime、桌面 App、Browser | 组合下层能力,不应被某个运行时反向绑死 |
这里最需要纠正的缩写是 ONNX:ONNX 是开放模型表示格式,ONNX Runtime 才是执行 ONNX 模型的运行时。 只说“我们集成了 ONNX”,可能表示能导入 .onnx 文件,也可能表示已经打包并成功加载 ONNX Runtime,两者不是一回事。
这些方案各自负责什么
ONNX Runtime:通用、跨平台的推理运行时
ONNX Runtime 的核心价值是把训练框架和部署运行时解耦。模型先导出为 ONNX 计算图,运行时再通过 CPU、CUDA、DirectML、CoreML 等 Execution Provider 映射到目标硬件。官方将其定位为跨平台模型加速器,并同时提供原生、Node.js 和 Web 形态。Execution Provider 文档定义了硬件加速扩展边界;Node.js 安装矩阵则显示,预编译 onnxruntime-node 的 CPU 路径覆盖 Windows、Linux 和 macOS,但 DirectML 与 CUDA 只覆盖特定系统和架构。浏览器场景另由 ONNX Runtime Web 覆盖。
它最适合这些任务:
- Embedding、分类、排序、OCR、语音、检测等输入输出相对稳定的模型。
- 需要 Windows、macOS、Linux 复用一套部署接口的产品。
- 希望模型制品和硬件加速后端保持相对独立的工程。
ONNX Runtime 也能运行部分生成式模型,但“能跑”并不等于“最适合把本地 LLM 产品化”。模型转换、算子支持、KV Cache、量化、采样器和长上下文优化都会进入成本模型。对于以 GGUF 生态为主的本地 LLM,llama.cpp 通常拥有更直接的工具链。
llama.cpp:面向本地 LLM / VLM 的原生推理引擎
llama.cpp 是一个以 C/C++ 为核心、围绕本地大语言模型和视觉语言模型构建的推理引擎。它支持 GGUF、量化、多种 CPU/GPU 后端,也提供本地 server,但它的核心仍是推理引擎,而不是完整的桌面模型商店。llama.cpp 官方仓库列出了 Metal、CUDA、Vulkan、SYCL 等硬件路径;其 server 文档则提供 OpenAI-compatible API、embedding 和 reranking 等接口。
它适合“应用要把生成式模型直接装进自己的进程或受控子进程”这一类需求:
- 产品随包或按需分发 GGUF 模型。
- 应用自己管理模型加载、释放、并发、上下文与崩溃恢复。
- 需要在 CPU 也能工作,同时尽量利用各平台 GPU 后端。
- 希望本地推理能力不依赖用户额外安装一个常驻服务。
Qwen 官方也直接提供了 Qwen3 使用 llama.cpp 的本地运行指南。不过具体模型是否满足 tool calling、长上下文、吞吐和内存目标,仍应通过目标量化制品和目标机器实测,而不是由“已支持模型名”推导。
MLX / MLX-LM:Apple Silicon 优先的机器学习栈
MLX 是 Apple 推出的机器学习框架,MLX-LM 是建立在其上的 LLM 工具层。它强调 Apple Silicon 的统一内存和数组计算体验,适合在 Mac 上做推理、微调和研究。MLX 官方仓库仍以 Apple Silicon 为核心,同时已经给出 Linux CPU 与 CUDA 安装方式;MLX-LM则提供模型生成、量化、微调和 server 等更贴近 LLM 的能力。
MLX 与 llama.cpp、ONNX Runtime 在 Apple 设备上会发生局部竞争,但它不是“所有平台都换成 MLX”的同义词。一个 Windows/macOS 双平台产品如果选择 MLX,通常意味着增加一条 macOS 专项实现和一套独立模型制品。只有当统一内存、模型适配或性能实测产生足够收益时,这条平台分叉才值得承担。
Ollama 与 LM Studio:同层的本地模型服务
Ollama 解决的是“让用户把本地模型装起来、管起来、通过稳定 API 调起来”。它提供模型拉取、模型配置、进程生命周期和本地 HTTP API;官方 API 默认使用本机环回地址、11434 端口与 /api 路径前缀,详见 Ollama API 文档。Ollama 当前源码也明确维护了对 llama.cpp 的依赖和构建说明,见 Ollama 的 llama.cpp 说明。
LM Studio 解决的是相近问题,但产品重心不同:它提供桌面图形界面、模型搜索与下载、聊天、Runtime 管理,以及 OpenAI-compatible 和 Anthropic-compatible API。LM Studio 在 macOS、Windows 和 Linux 上可以使用 llama.cpp 运行 GGUF;在 Apple Silicon Mac 上还支持 MLX 模型。详见 LM Studio 产品文档与 LM Studio API 文档。
它们与底层推理引擎的关系如下:
- 直接嵌入 llama.cpp,应用拥有更强的进程、模型和发布控制力,也承担更多原生集成成本。
- 调用 Ollama 或 LM Studio,应用获得统一 HTTP 边界和现成模型管理能力,但要接受额外安装、端口、常驻进程、版本兼容和权限诊断成本。
- Ollama 与 LM Studio 是同层竞品;它们与 llama.cpp、MLX 是上下层关系,不是简单的四选一。
若应用同时提供 Ollama 与 LM Studio 两个可选 Provider,可以复用 OpenAI-compatible 适配机制。Provider 管理配置、连接、鉴权和模型标识;本地服务的安装与模型生命周期需要另行说明。
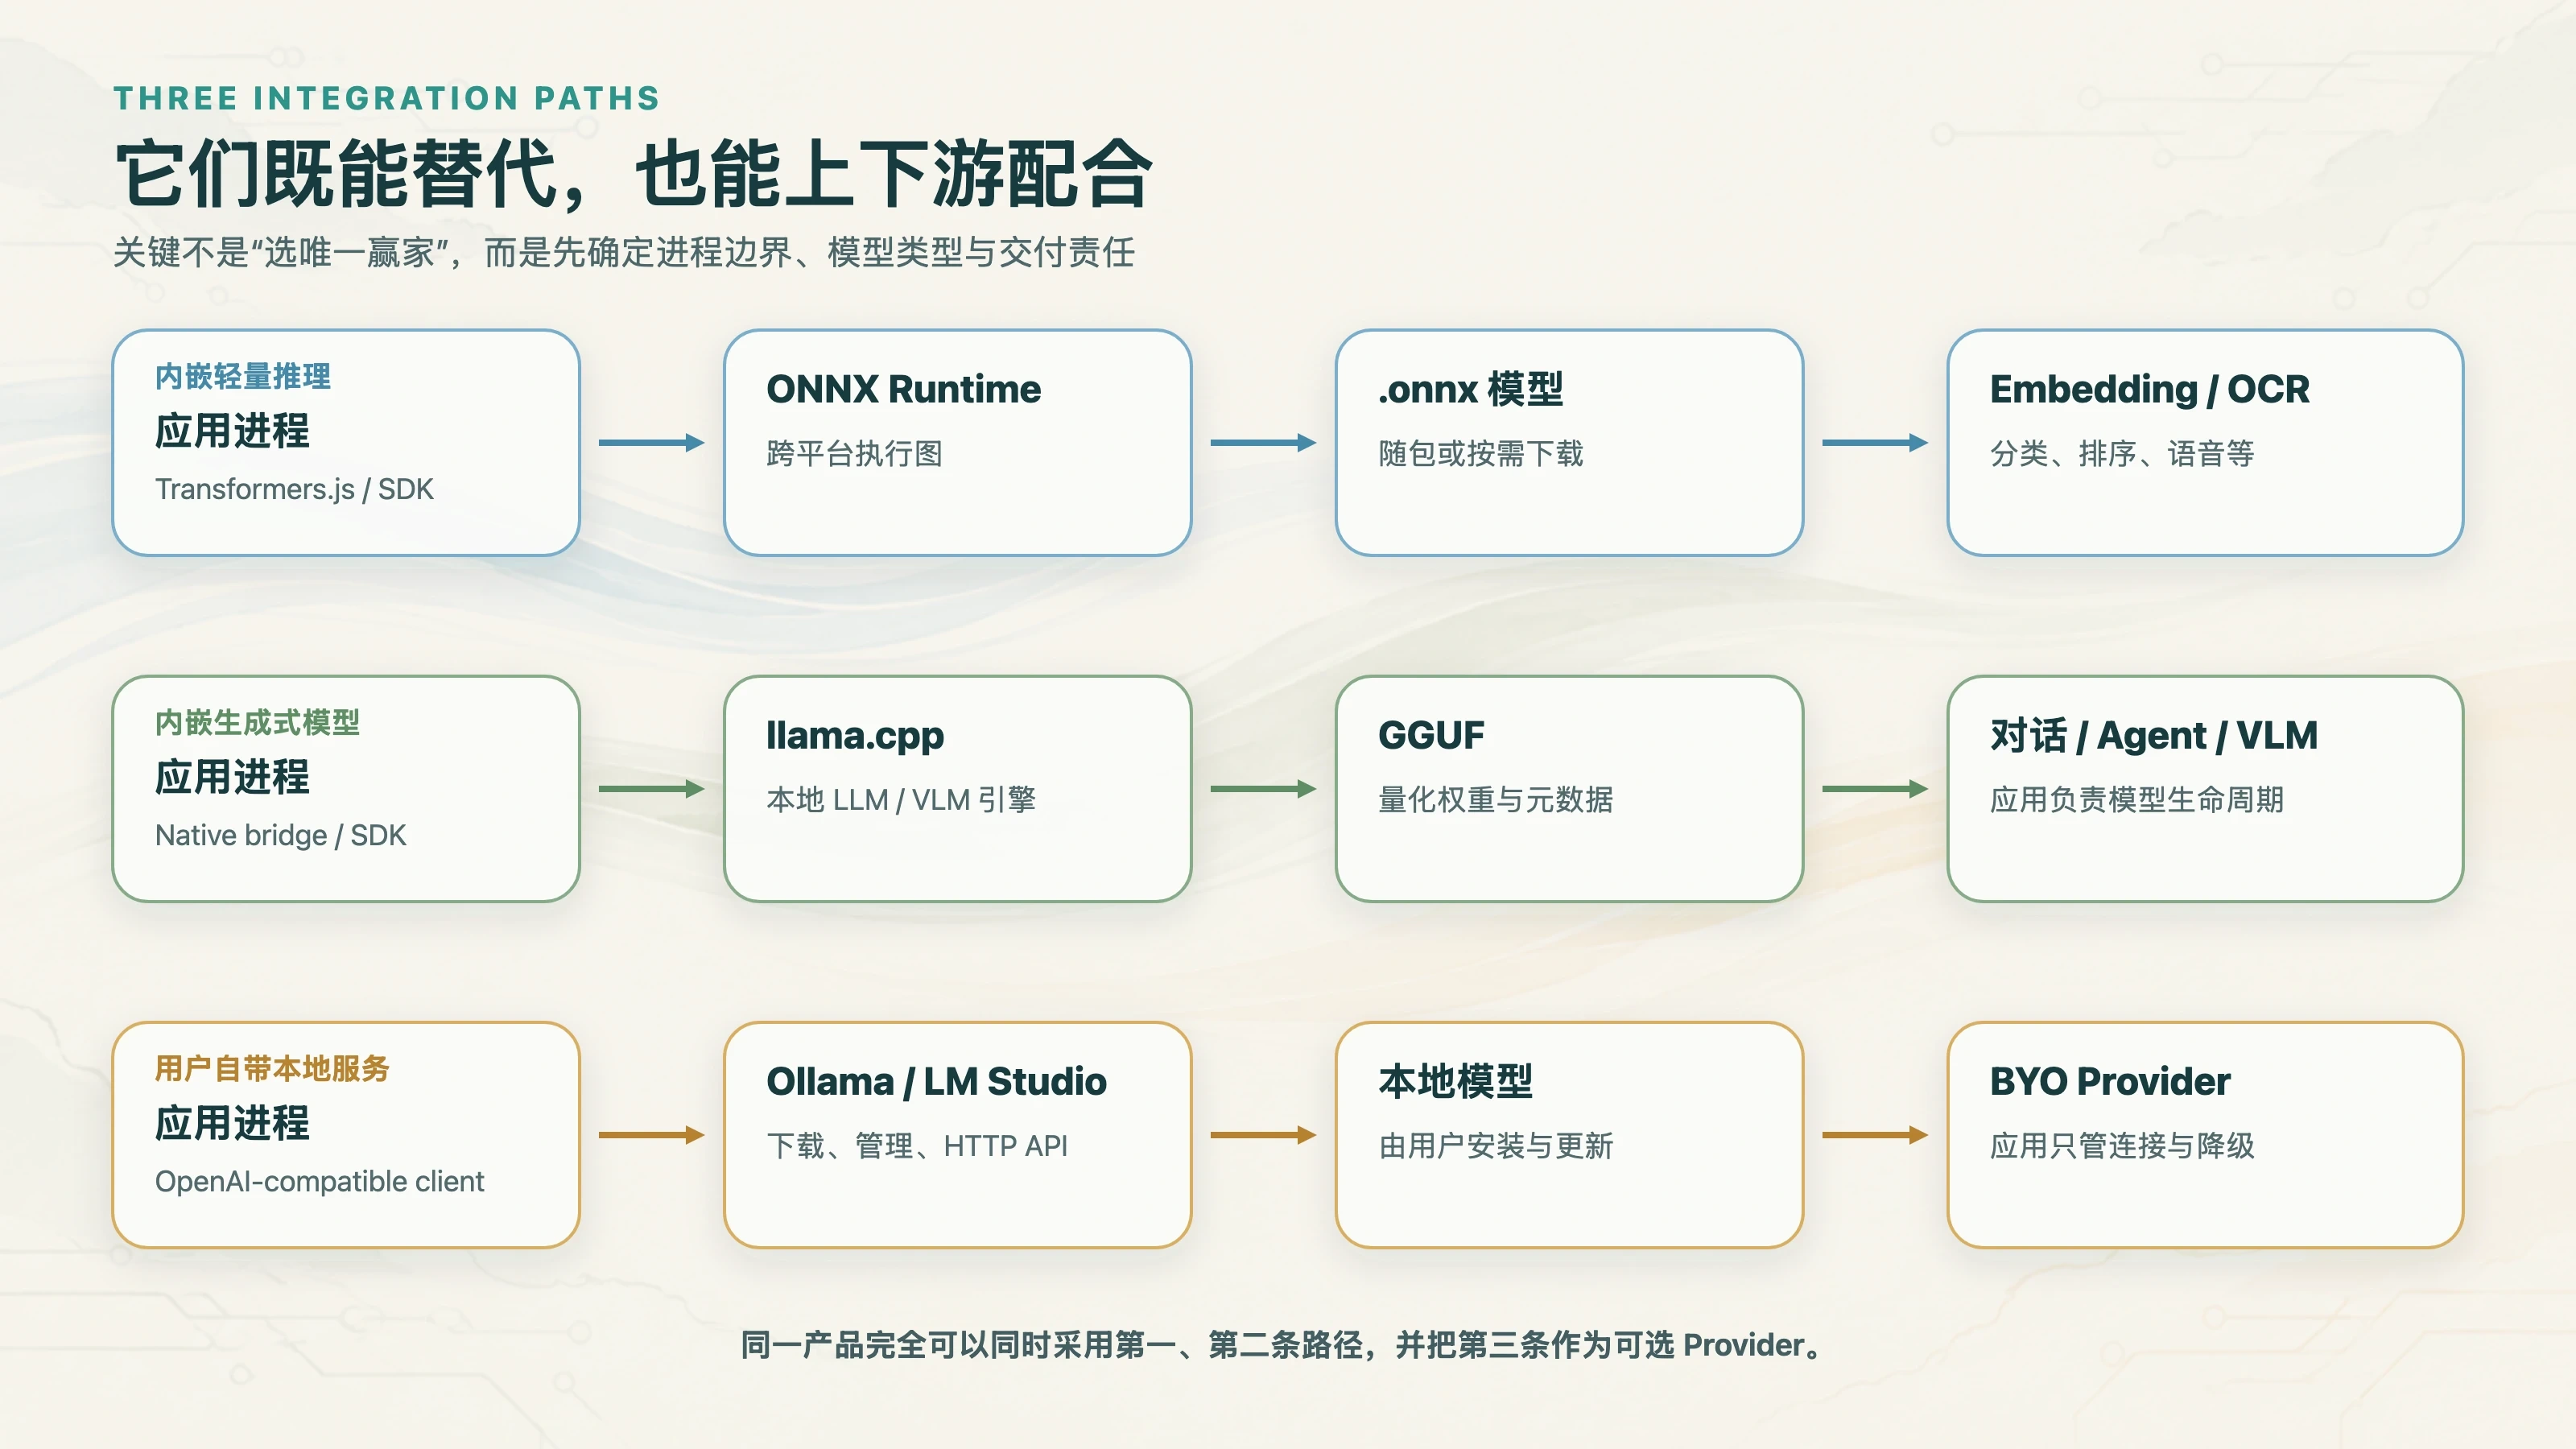
它们怎样配合:三条典型路径
路径一:应用内嵌 ONNX Runtime
这条路径适合语义检索、Embedding、分类、OCR 等轻量能力。应用通过 Transformers.js 或自己的 SDK 加载 .onnx 模型,推理发生在应用进程或受控 worker 中。模型体积、原生依赖、缓存目录和硬件后端都属于应用交付链的一部分。
它的优势是跨平台接口清晰、能力边界稳定;代价是 Distribution 必须真正解决原生包安装脚本、签名、模型缓存和冷启动,而不能只看到 node_modules 中存在包名就宣布能力已集成。
路径二:应用内嵌 llama.cpp
这条路径适合产品自带本地对话、Agent 或 VLM。应用通过 Native bridge 调用 llama.cpp,模型通常以 GGUF 交付。产品可以统一控制启动、资源上限、模型版本和降级,也必须承担 ABI、量化制品、GPU 后端和不同平台打包的复杂度。
这里的关键决策不是“llama.cpp 性能好不好”,而是“本地生成式模型是否是产品必须随包保证的能力”。如果答案是肯定的,内嵌引擎比把用户安装 Ollama 或 LM Studio 作为硬依赖更可控。
路径三:应用连接 Ollama 或 LM Studio
这条路径适合开发调试、专业用户自带模型,以及不希望应用接管模型分发的场景。应用通过 OpenAI-compatible Provider 连接 Ollama 或 LM Studio,模型下载、量化选择和更新由用户或本地服务负责。
它非常适合作为可选 Provider,却不应轻易成为面向普通用户的唯一端侧路径。否则“端侧能力”实际上依赖用户预装服务、端口可用、版本匹配和模型已下载,产品必须把这些条件做成可诊断状态。
什么时候用什么
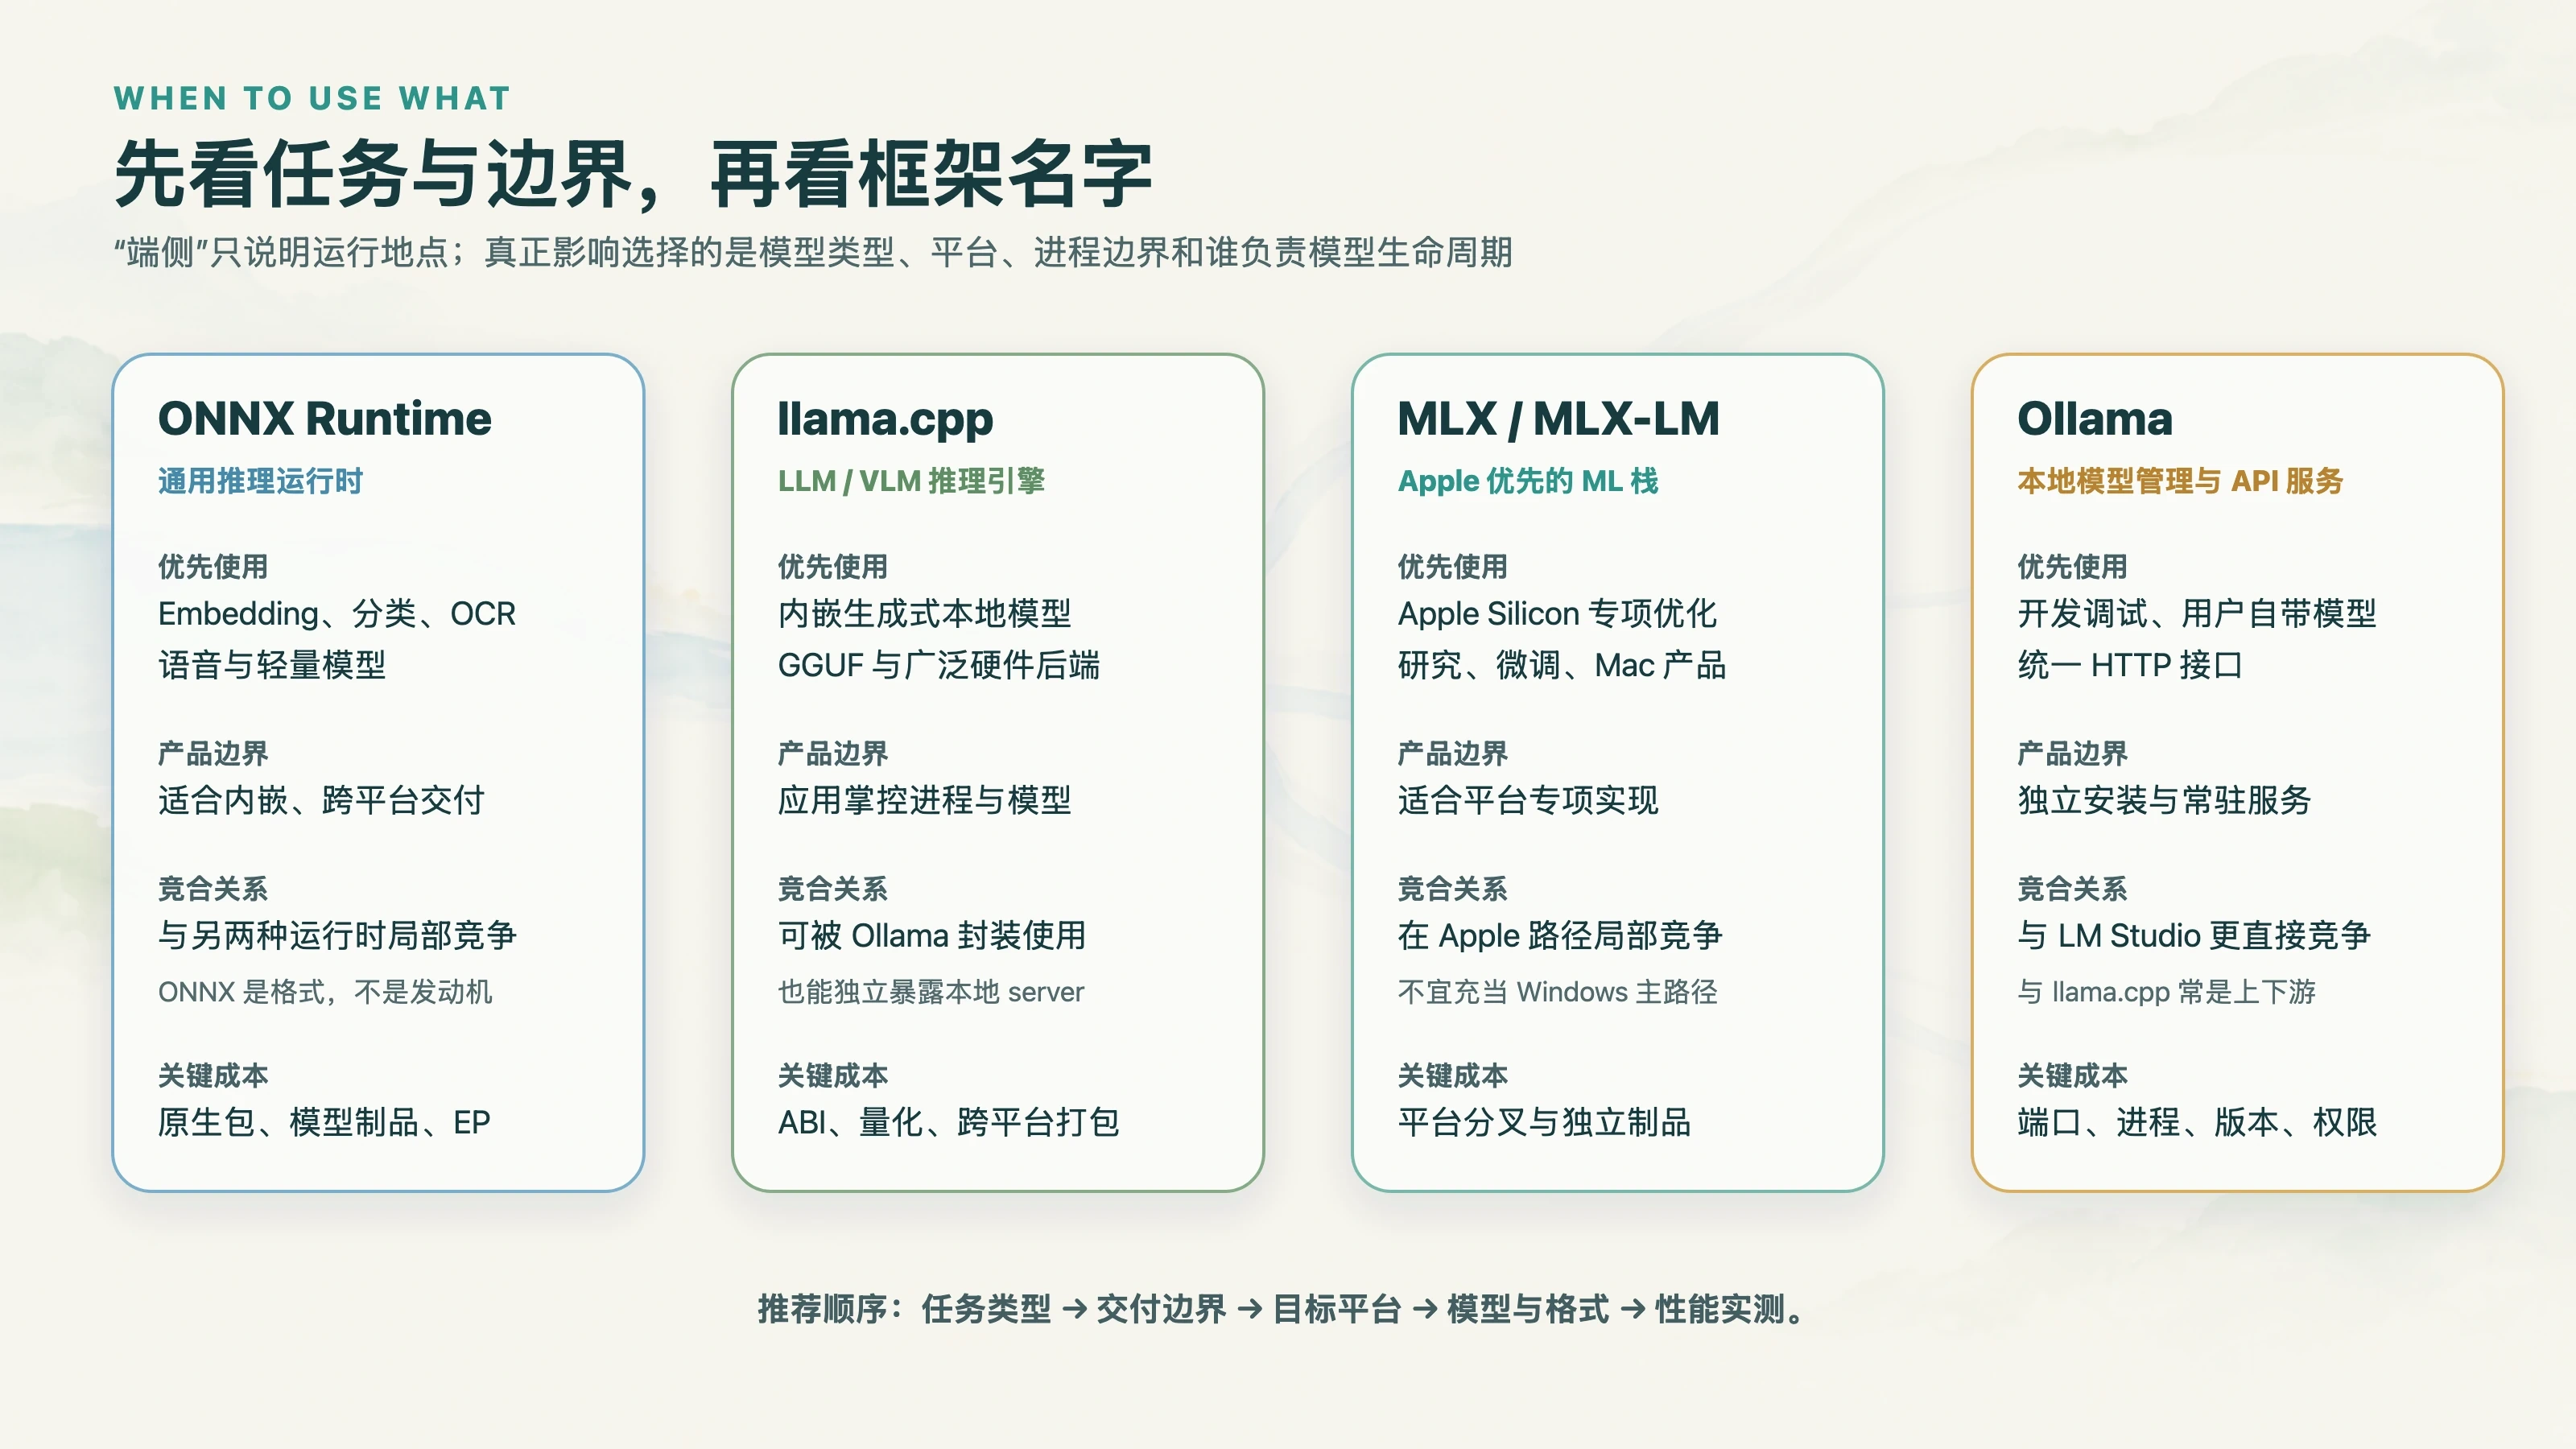
可以按下面的顺序做判断,而不是先站队某个框架。
1. 先看任务类型
Embedding、分类、OCR、语音等稳定计算图优先评估 ONNX Runtime。对话、Agent、代码生成、VLM 等 autoregressive generation 优先评估 llama.cpp 或平台专项的 MLX / MLX-LM。不要因为两类任务都叫“AI”就强行共用一个运行时。
2. 再看交付边界
如果能力必须开箱即用,运行时、模型、缓存和回退都应由产品受控,适合内嵌 ONNX Runtime 或 llama.cpp。如果目标用户愿意自行安装和管理模型,Ollama 或 LM Studio 可以作为 BYO Provider。谁负责模型生命周期,比“API 长得像不像 OpenAI”更重要。
3. 然后看目标平台
跨 Windows、macOS、Linux 的主路径优先选择跨平台运行时;Apple Silicon 专项能力可以评估 MLX。专项优化应建立在同模型、同量化、同输入、同输出质量的基准之上,不能只比较一次 token/s。
4. 最后才看模型格式和性能
模型家族、量化、上下文长度、内存峰值、首 token 延迟、稳态吞吐、工具调用正确率和制品体积要一起测。格式转换不是免费的:一个模型从原始权重转换为 ONNX、GGUF 或 MLX 权重后,支持的算子、量化方式和输出质量可能发生变化。
下面这张简表可以直接用于方案评审:
| 需求 | 首选方向 | 原因 | 需要额外证明 |
|---|---|---|---|
| 跨平台 Embedding / 分类 / OCR | ONNX Runtime | 通用计算图和硬件后端边界清晰 | 原生包、Execution Provider、模型缓存、冷启动 |
| 产品内置本地 LLM / VLM | llama.cpp + GGUF | 本地生成式生态成熟,应用可控 | ABI、量化、内存、工具调用、平台打包 |
| 只做 Apple Silicon 专项能力 | MLX / MLX-LM | 统一内存和 Apple 生态适配 | 相对 llama.cpp 的实测收益、平台分叉成本 |
| 开发者或用户自带本地模型 | Ollama / LM Studio Provider | 下载、管理和 HTTP API 已封装 | 安装检测、端口、版本、模型存在性、降级 |
| 同时有语义模型和生成式模型 | ONNX Runtime + llama.cpp | 不同任务使用各自更合适的引擎 | 两套资源预算和模型生命周期 |
| 既要开箱即用又要允许自带模型 | 内嵌运行时 + 可选 Ollama / LM Studio | 默认体验可控,高级用户可扩展 | Provider 优先级、健康检查和一致的权限策略 |
我的判断框架
我会用一句话记住五者:
ONNX Runtime 跑通用计算图,llama.cpp 跑跨平台本地生成式模型,MLX 做 Apple 平台专项,Ollama 与 LM Studio 管理并对外提供本地模型服务。
真正做方案时,再追问四个问题:任务是语义模型还是生成式模型;能力必须随产品交付还是允许用户自备;目标平台是跨平台还是 Apple 专项;模型生命周期由应用、Distribution 还是用户负责。
回答完这四个问题,绝大多数“到底选 ONNX Runtime、llama.cpp、MLX、Ollama 还是 LM Studio”的争论都会自然消失。因为工程上真正要选的从来不是一个名词,而是一条可以被构建、签名、安装、诊断和验收的完整运行路径。
参考资料
- ONNX Runtime documentation
- ONNX Runtime Node.js binding
- ONNX Runtime Execution Providers
- ONNX Runtime Web
- Transformers.js server-side inference in Node.js
- Transformers.js custom usage
- ggml-org/llama.cpp
- llama.cpp server
- Qwen3 with llama.cpp
- ml-explore/mlx
- ml-explore/mlx-lm
- Ollama API
- Ollama llama.cpp integration notes
- LM Studio product documentation
- LM Studio REST API