漫画拆解 agent-browser:从网页快照到动作验证
俊宁 · 2026-11-01文章目录
通过 snapshot 原理漫画与公开源码,拆解 agent-browser 的语义观察、元素引用、动作执行与结果核验边界。
本文讨论通用机制和设计判断;示意不对应任何具体产品的已交付状态。源码阅读坐标沿用原稿,本次整理不构成新的运行时验收。
给 Agent 一句“查一下《网络基础》有没有库存”,需要完成的是一串具体工作:打开书店,找到搜索框,填入书名,触发查询,再确认结果对应的是这本书。网页上的某次点击成功,只能证明一个动作完成了,距离回答用户的问题还差一次结果核对。
agent-browser 把观察网页和操作浏览器整理成了命令行接口。这篇借小界和小南的一次查询,把这些接口串成一个完整任务,再说明工具与 Agent 各自承担什么。漫画中的书店、库存和命令输出均为教学示意,不是实际业务执行记录。
一句话总结
agent-browser 的核心定位是面向 AI Agent 的浏览器自动化 CLI,提供网页观察、元素引用和浏览器动作;基础命令通常由上层 Agent 决策调用。实现需要按版本区分:0.19.0 默认走 Node.js + Playwright,0.41.1 默认 Chrome 路径走 Rust daemon + CDP。
理解这项分工,才能看清两个容易混淆的问题:@e1 为什么能指向一个控件,以及执行了 click 为什么还不能直接宣布任务成功。
本文按 2026 年 11 月 1 日核验的上游 0.41.1 版本与官方文档解释,默认讨论 Chrome / CDP 路径。已有系统若固定在旧版本,需要分别核对实现,不能把新版原理直接套到旧适配器上。版本依据
定位是 Agent 工具,实现要按版本区分
“SDK 还是 Agent”混合了两个问题:SDK、CLI 描述怎样接入,Agent 描述谁承担模型决策循环。agent-browser 的核心定位是面向 AI Agent 的浏览器自动化 CLI。通常由外部 Agent 理解目标、选择命令并核对结果,工具负责观察、动作和会话。官方定位
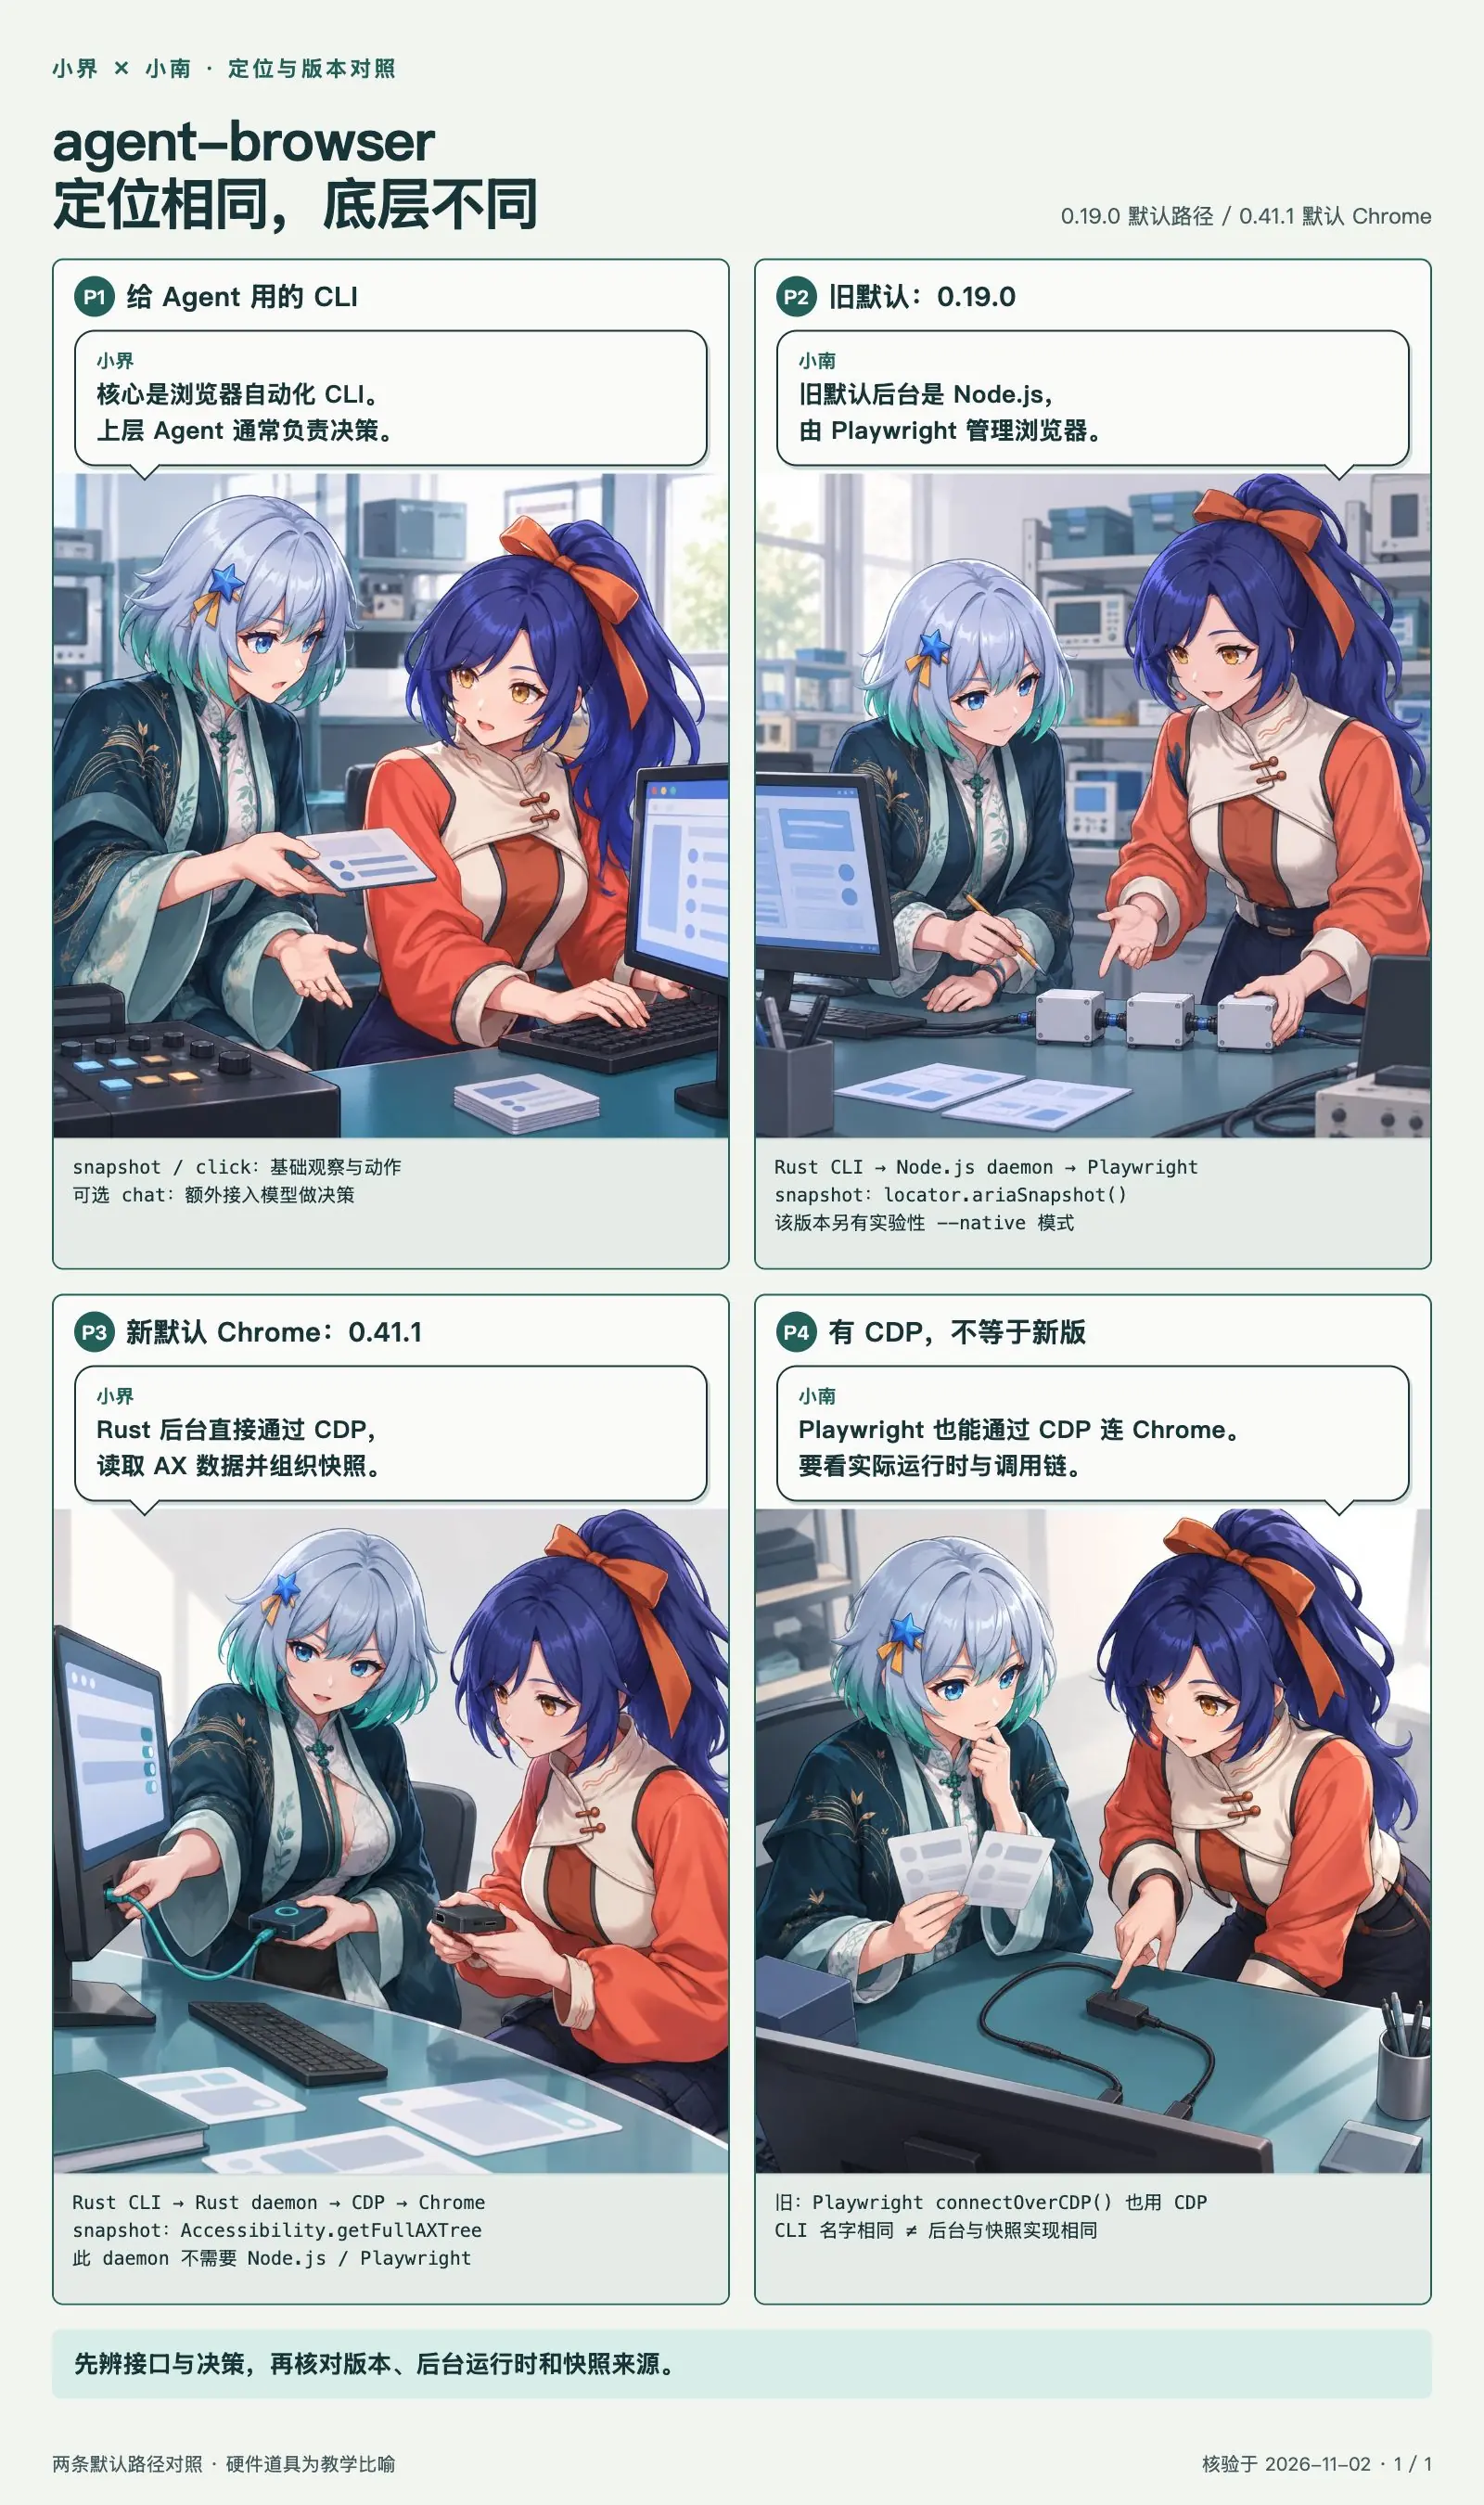
核心命令与可选 chat 模式
snapshot、click 等基础命令不靠 LLM 决定业务下一步。0.41.1 也提供可选的 agent-browser chat:配置模型后,将自然语言转成命令并执行。因此,不能把整个项目概括为“完全没有 Agent 能力”;本文的调用链对照主要解释基础工具层,可选 chat 在其上增加模型决策入口。AI Chat 说明
旧默认路径与新默认 Chrome 路径
| 对照项 | 0.19.0 默认路径 | 0.41.1 默认 Chrome 路径 |
|---|---|---|
| CLI | Rust CLI,解析并传递命令 | Rust CLI,解析并传递命令 |
| 后台运行时 | Node.js daemon,管理 Playwright 浏览器实例 | Rust daemon,直接使用 CDP 驱动 Chrome |
| 快照来源 | locator.ariaSnapshot(),再加工文本与引用 | Accessibility.getFullAXTree,再构树、关联引用并过滤输出 |
| daemon 关键依赖 | Node.js、Playwright | 不需要 Node.js 或 Playwright |
0.19.0 默认 CLI 路径:
外部 Agent → Rust CLI → Node.js daemon → Playwright → 浏览器

0.41.1 默认 Chrome 路径:
外部 Agent → Rust CLI → Rust daemon → CDP → Chrome
这些箭头描述 CLI 入口。若项目通过 SDK 在 Node.js 进程内直接导入 BrowserManager,则可能绕过 CLI 和独立 daemon;确认本机 CLI 版本,不能替代确认 SDK 实际解析的依赖版本。
SDK 包版本与底层浏览器包版本也要分别看。2026 年 11 月 2 日核对 npm 发布信息时,@mastra/agent-browser 的稳定版为 0.6.0,其 dependencies 仍固定 agent-browser: "0.19.0"。因此,升级这个适配器并不自动切到上游 0.41.1 默认 Chrome 的 Rust 原生路径。Mastra 适配器 0.6.0 发布元数据
关键变化包括后台运行时和浏览器控制层,不能简化成“旧版是 Node CLI,新版才有 Rust CLI”:0.19.0 的默认 CLI 就已经是 Rust;该版本还提供实验性、需选择启用的 --native Rust daemon。上表比较的是两版指定的默认路径,不代表 0.19.0 只有 Playwright,也不把 0.41.1 的其他引擎都归成 Chrome。0.19.0 架构与 native 模式、0.41.1 运行要求
两个版本的快照也不能混讲。旧路径的 ARIA snapshot 由 Playwright 生成,再加工引用;本文核验的新 Chrome 路径直接请求浏览器的原生 AX 数据,再进行工具侧整理。后者仍包含 DOM 范围筛选和其他补充处理,不能推成纯 AX-only 系统。旧版快照源码、新版快照源码
还有一个容易误判的线索:旧版 Playwright 也能通过 connectOverCDP() 连接 Chrome。看到 CDP 地址、Chrome 进程或相同的 CLI 命令,都不足以认定已经使用新版 Rust 原生路径。需要同时检查依赖版本、所选运行模式、后台进程和实际调用链;本文不据此推断两版速度或成功率。旧版 CDP 连接实现
第一幕:把“查库存”变成网页上的动作
(此版本省略该配图。)
小界拿到的是业务目标:“查《网络基础》的库存。”小南需要把这个目标落实到页面控件:哪个输入框接受书名,哪个按钮发起查询,哪里能读到结果。
打开网页之后,snapshot 返回一份带引用的紧凑无障碍语义快照。角色和名称帮助 Agent 判断控件用途,引用则用于后续命令。snapshot -i 偏向可引用的操作目标,适合先找输入框、链接和按钮;具体保留范围见后文的裁剪说明。快照选项
下面将漫画中的操作写成命令。book.example 是示意域名,引用编号也是示例;实际使用时必须换成目标页面,并读取真实快照。
agent-browser open https://book.example
agent-browser snapshot -i
假设快照里出现“搜索书名”输入框 @e1 和“搜索”按钮 @e2,接下来可以执行:
agent-browser fill @e1 "网络基础"
agent-browser click @e2
这里发生了两次不同的转换。Agent 根据角色、名称和任务目标,选择应该操作哪个控件;agent-browser 根据引用定位元素,再完成填写或点击。控件“叫什么”有助于决策,控件“指向哪里”支撑执行,二者缺一都会影响操作。
这也解释了语义信息的价值:页面若把搜索按钮暴露成一个有明确名称的 button,Agent 就有直接证据。若它只是一块没有名称的图形,单靠这份语义观察可能无法确定用途,需要补充截图、上下文或其他受控读取。
snapshot 内部:从 AX Tree 到可操作引用
snapshot 的采集、引用管理和格式整理由工具代码完成,工具不会调用 LLM 来生成页面语义。模型得到这份观察后,再决定下一步动作。下面八格漫画将这段过程拆开,仍以本文核验的 Chrome 原生路径为准。
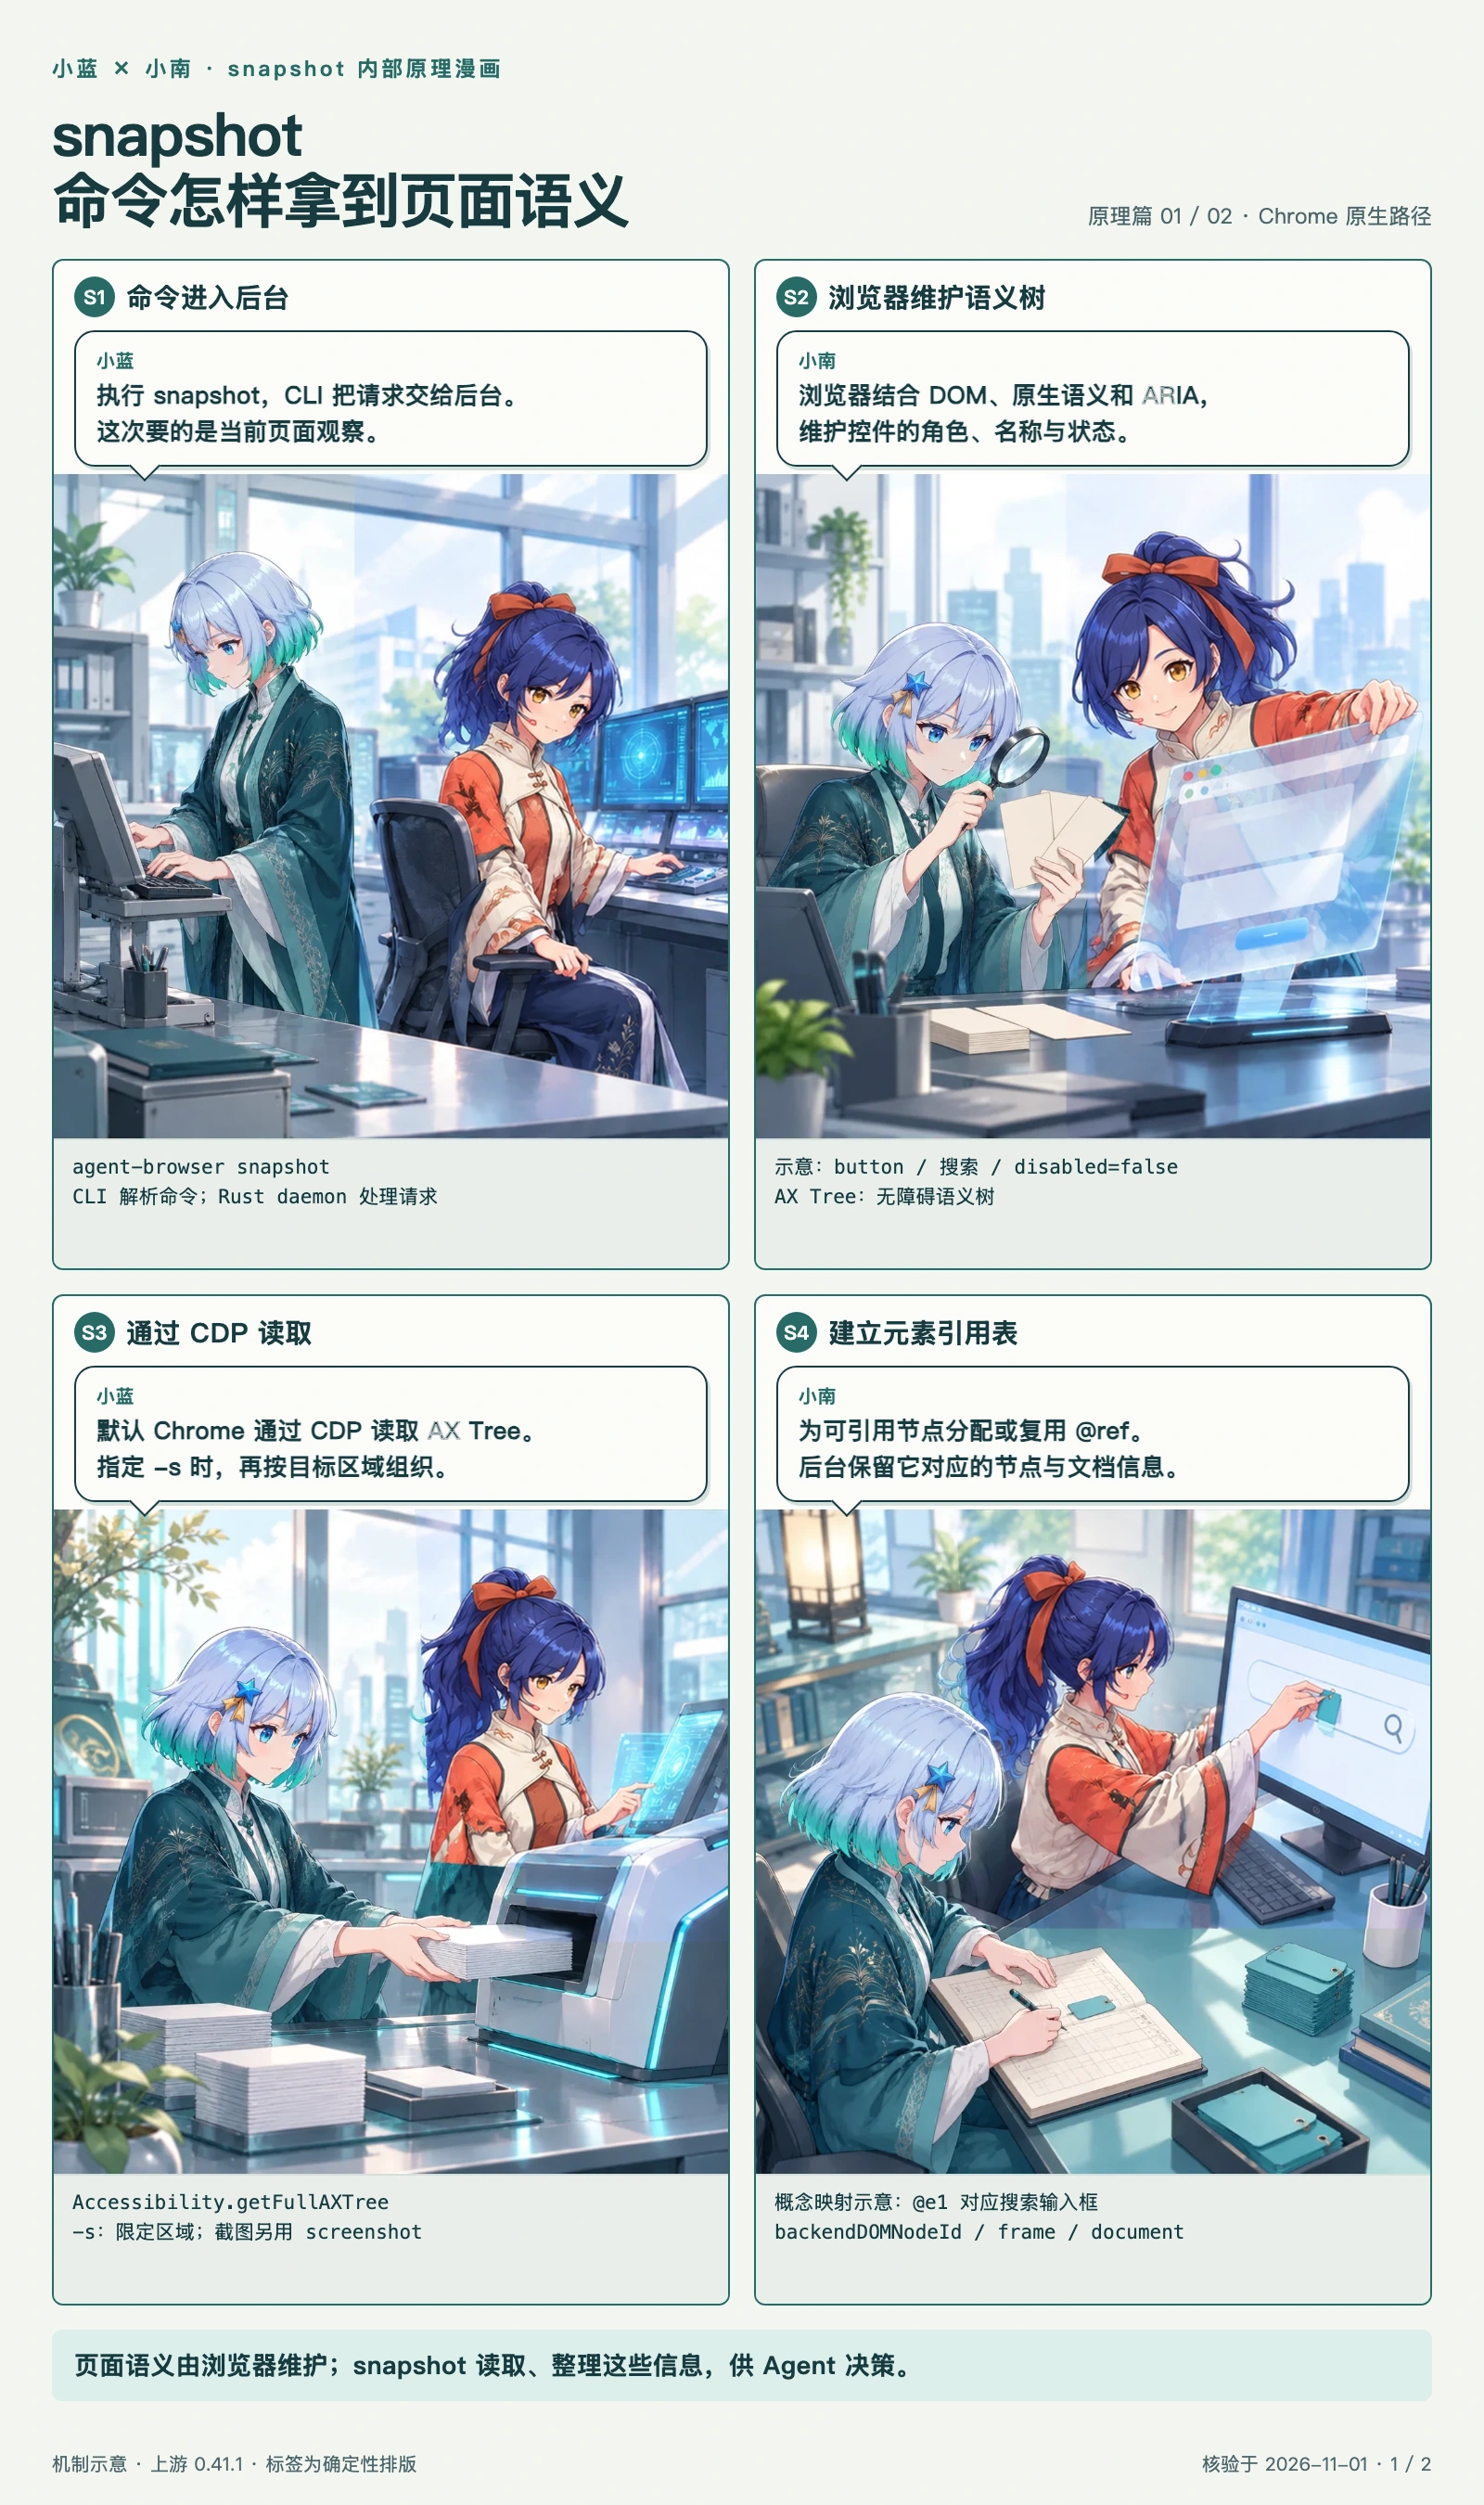
AX 是 Accessibility(无障碍)的常用缩写,AX Tree 即 Accessibility Tree,无障碍树。浏览器根据 DOM、原生 HTML 语义、ARIA 属性及元素状态维护这份语义表示。工具通过 Accessibility.getFullAXTree 取得节点信息,再组织角色、名称、状态和层级。指定 -s 时,会结合目标 DOM 子树筛选范围。生成引用时,后台保留引用与节点、frame 和文档的关联;后续文本中出现的 @e1 因而能回到浏览器中的具体目标。固定版本快照源码
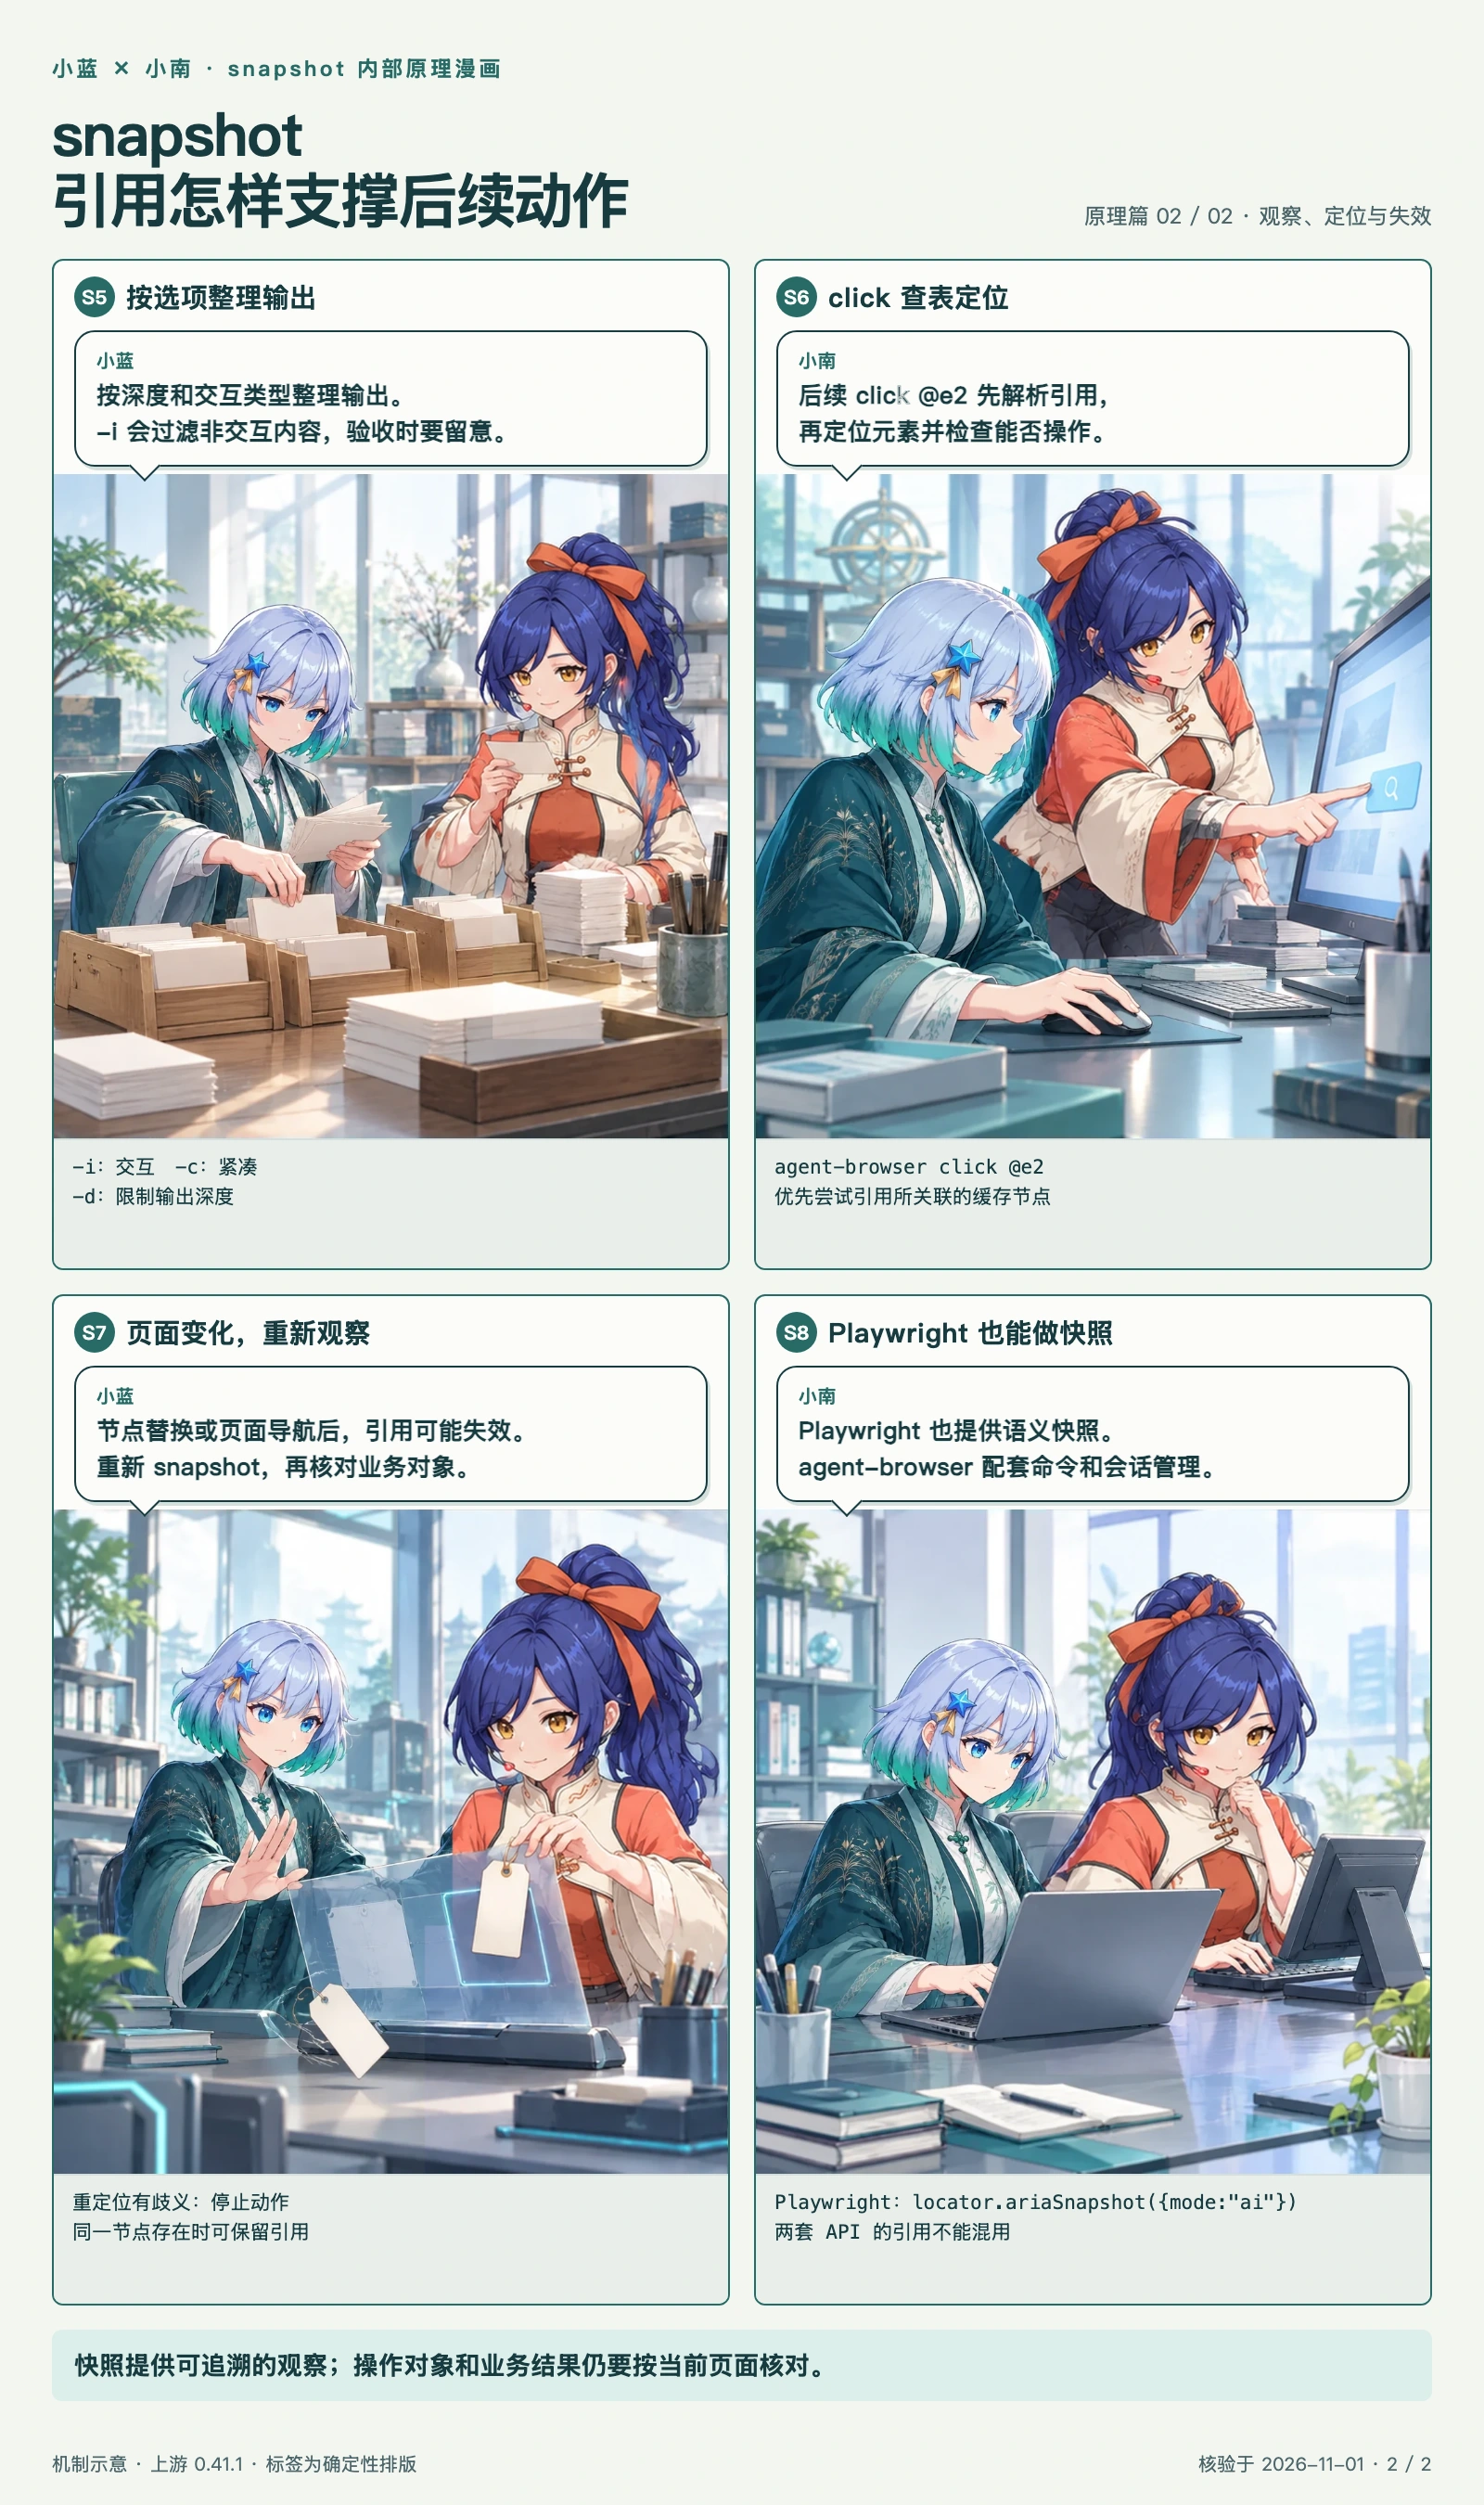
这些信息随后按输出选项整理成紧凑文本。-i 偏向交互目标,-c 压缩空的结构分支,-d 限制展示深度。它们控制观察的体积与范围,不负责理解库存、订单等业务含义。读取 AX Tree 也不代表整套工具只使用 AX 信息:当前实现还包含 DOM 范围解析、可点击线索补充等处理,不能把这张漫画理解为纯 AX-only 约束。
执行 click @e2 时,后台解析此前保存的引用,优先尝试关联的缓存节点,再进入元素定位和可操作性处理。节点替换或文档导航会影响这项关联;角色与名称恢复存在歧义时应停止动作。引用让观察和动作有了对应关系,业务对象与最终结果仍需调用方核对。固定版本引用解析源码
Playwright 同样提供 locator.ariaSnapshot();当前文档中的 mode: "ai" 还支持带引用的 AI 快照。因此,agent-browser 的价值主要在于把观察、引用、动作命令和跨命令会话管理配套提供。两套 API 的快照引用各自属于其工具上下文,不能拿一套工具生成的编号去调用另一套工具。Playwright 快照 API
所谓“DOM 剪枝”,实际裁剪的是页面观察
面对节点很多的页面,首先要区分三个对象:浏览器正在运行的 DOM、浏览器维护的 AX 语义树,以及最后送给模型的文本快照。本文这条路径更适合称为页面观察裁剪,具体包括语义投影、结构压缩和快照输出过滤。这些处理不会把网页里的 DOM 节点删除,也不会改变页面的业务状态。
这里继续以本文固定的 0.41.1 Chrome 原生实现为依据,补充核验日期为 2026 年 11 月 2 日。漫画中的卡片和书店结果都是教学示意。
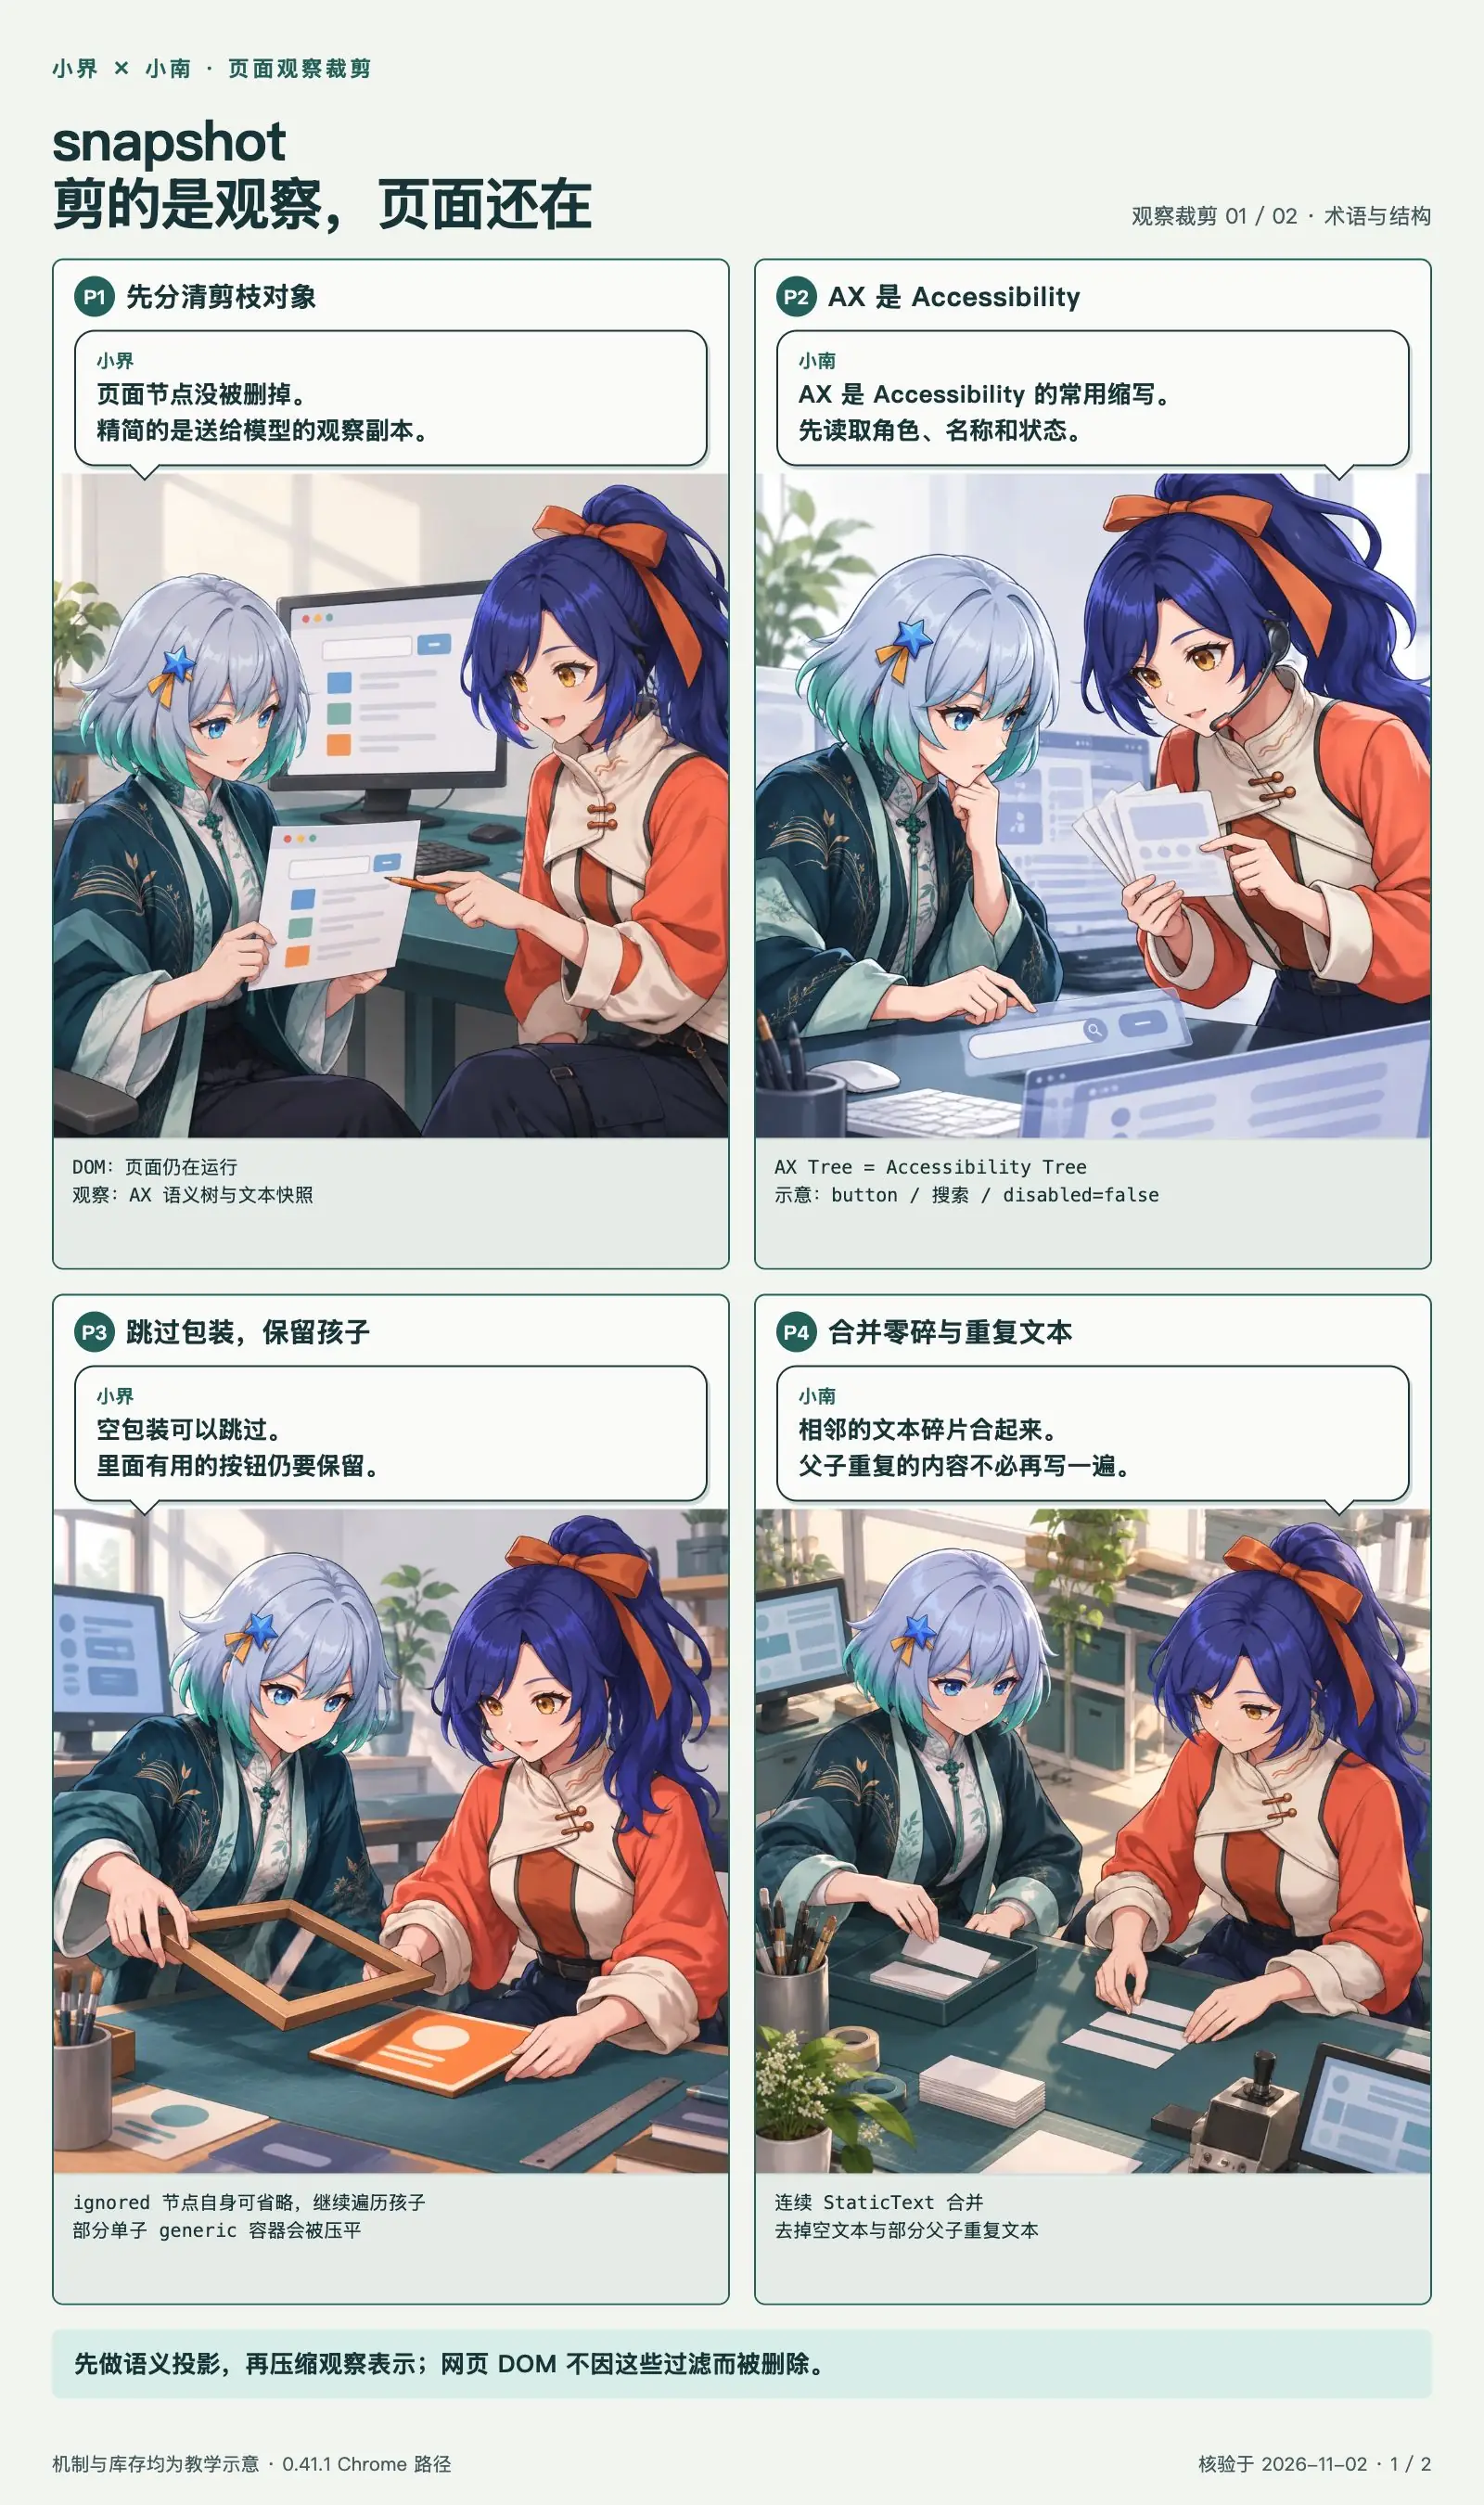
先做语义投影,再压缩结构
从 DOM 换到 AX Tree,是把页面表达成角色、名称和状态等语义信息,不是逐字缩短 HTML。随后,工具跳过部分包装节点自身,继续遍历它们的孩子;压平符合条件的单子 generic 容器;合并连续 StaticText,清除空文本和部分父子重复文本。跳过包装仍须让有效子节点进入观察,不能把整个有用分支一起丢掉。结构整理与遍历源码
这些都是工具代码执行的规则。哪些内容对“查库存”有业务意义,需要上层根据任务选择观察范围和读取方式。
按范围和用途过滤,保留必要的上下文
| 选项 | 裁剪方式 | 使用时要核对什么 |
|---|---|---|
-s "#results" | 组织指定 DOM 子树对应的观察 | 目标、状态和结果是否都在范围内 |
-d 5 | 限制输出展示层级 | 深层的控件或证据是否被截掉 |
-c | 保留有引用、文本或值等内容的行及其祖先链,去掉空分支 | 紧凑输出是否仍能说明内容属于哪个区域 |
-i | 按可引用节点过滤输出,偏向操作目标 | 普通结果正文和错误提示是否消失 |
官方文档把 -i 概括为交互元素模式。但本文固定源码用的是 has_ref 条件,表格单元格及部分具名标题、区域也能获得引用,因此不能将它理解为“严格只剩可点击控件”。普通文字仍可能被过滤;“快照没出现”不能证明“页面没有”。官方选项、引用分配、输出与紧凑处理
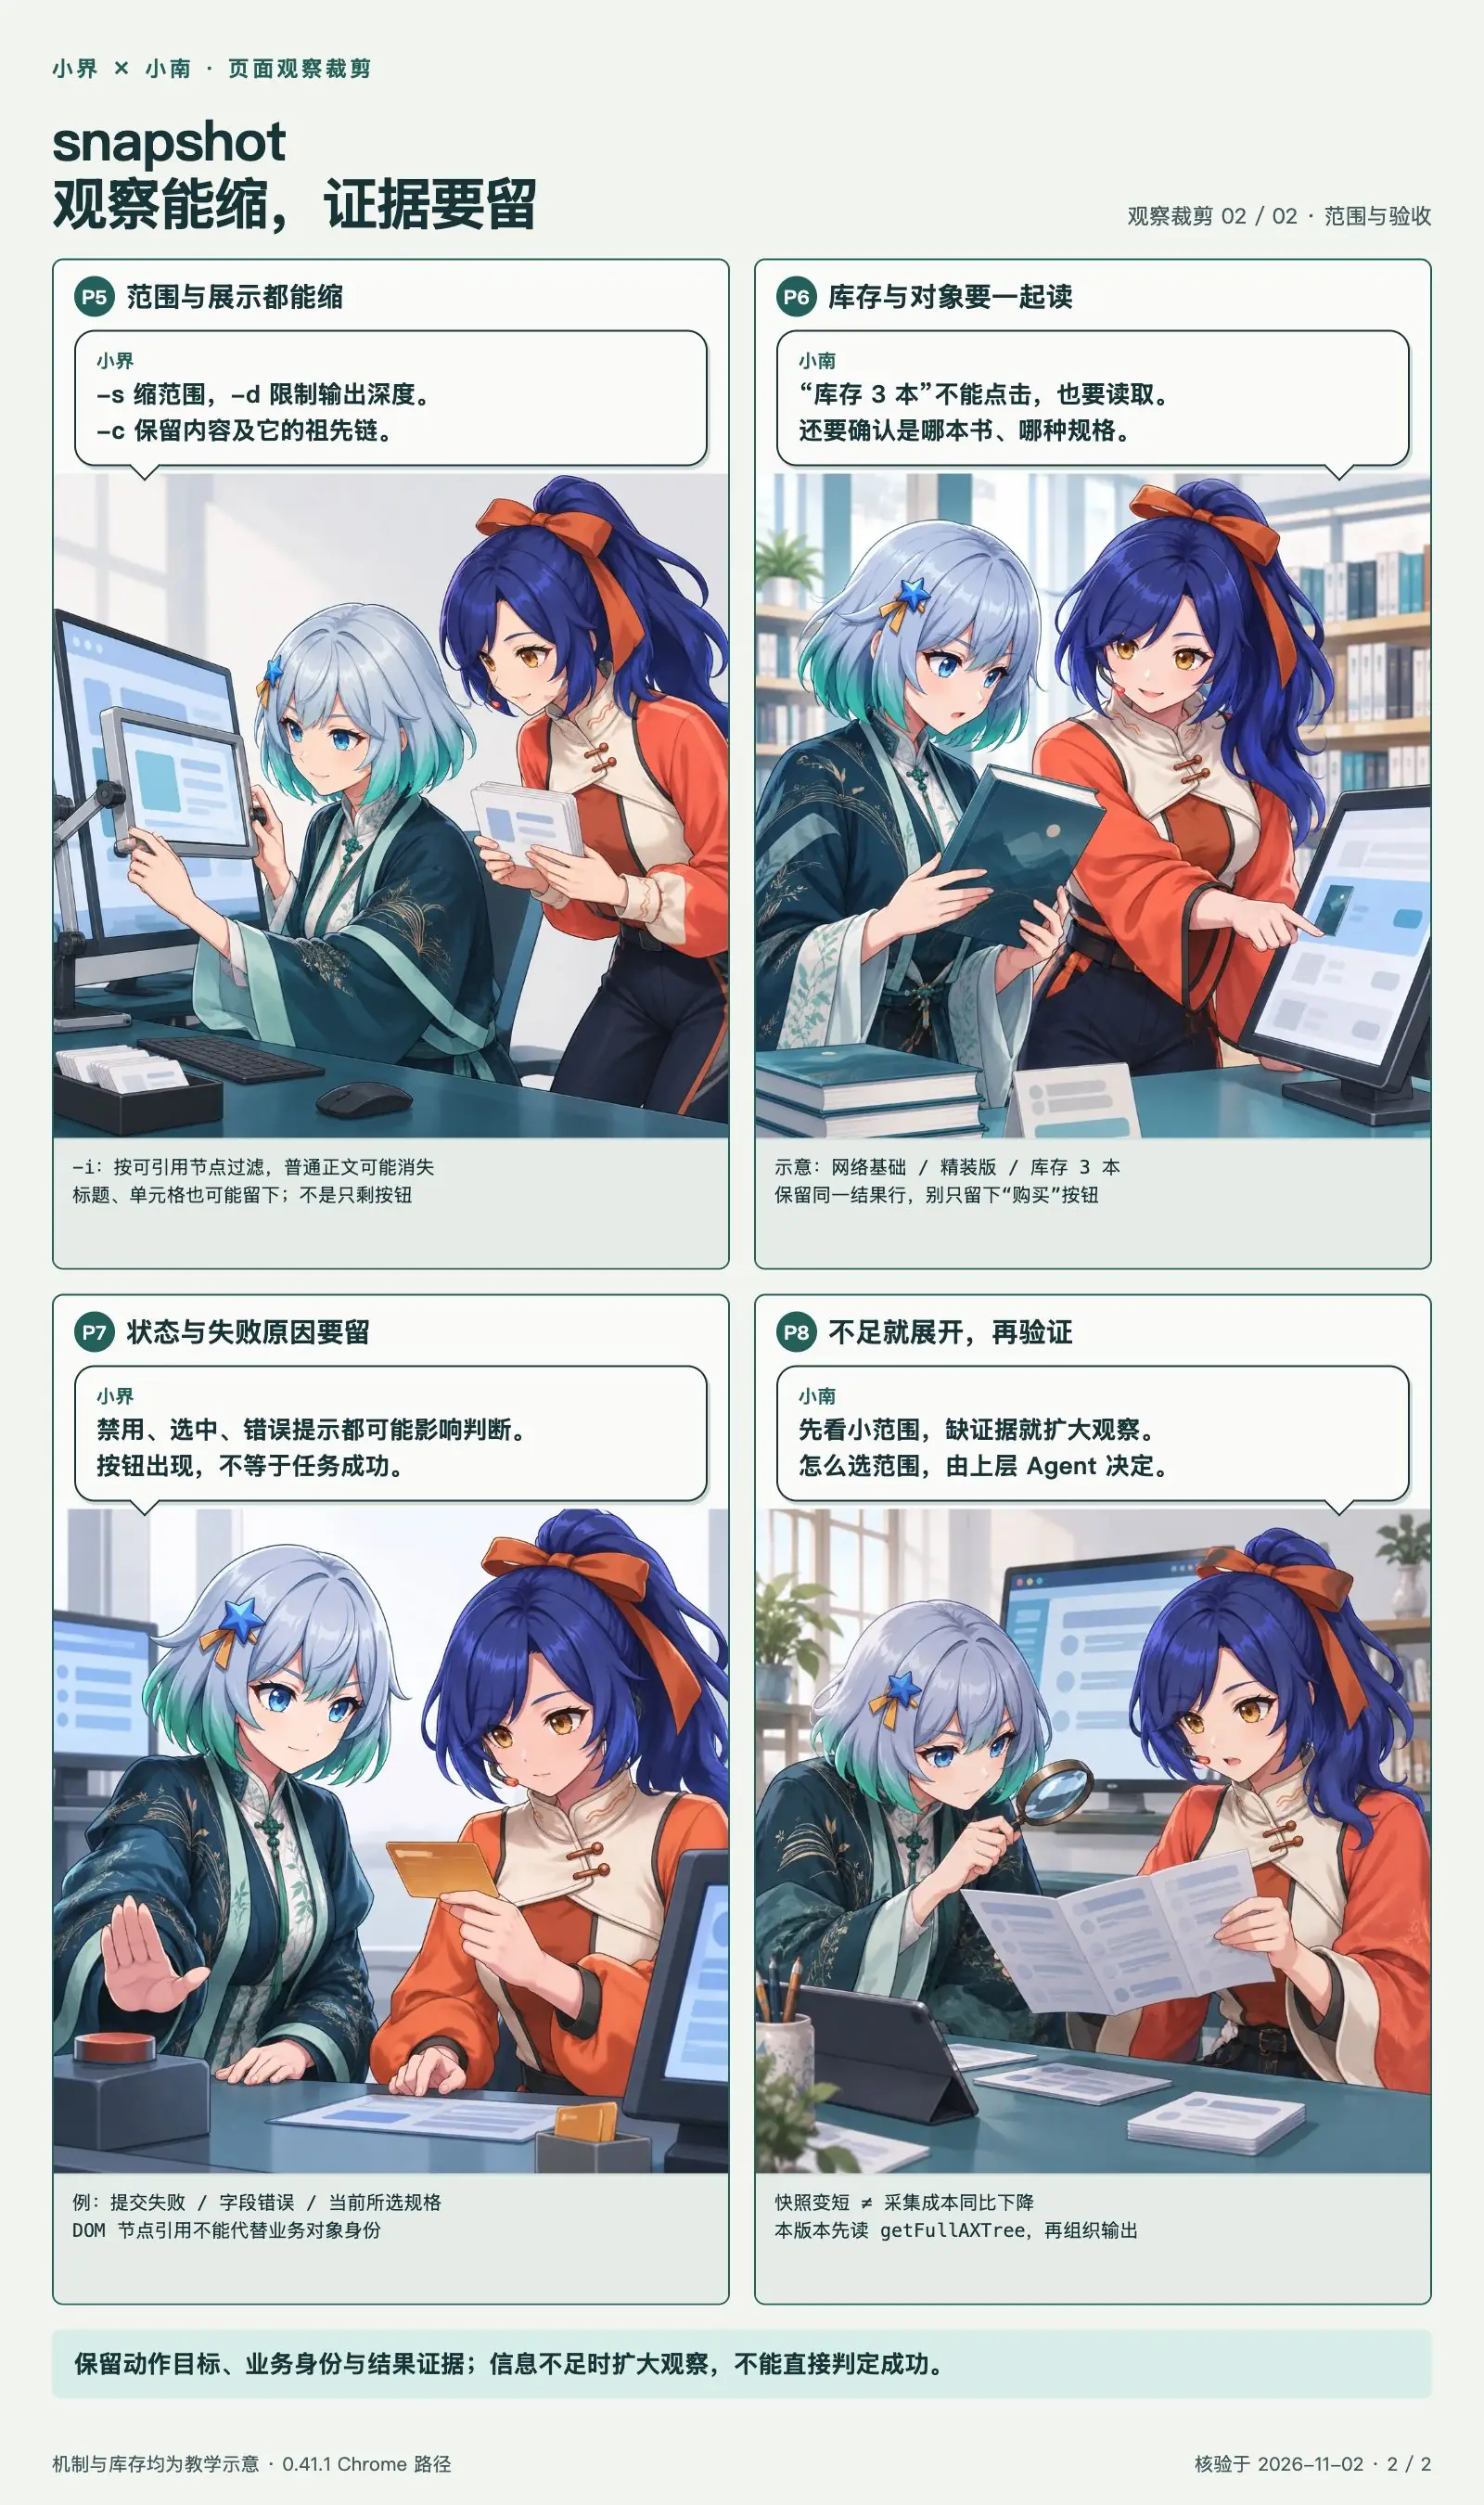
哪些信息不能因为“不能点击”就丢掉
假设书店把结果标题暴露为 heading,把库存暴露为普通文本,观察可以简化表示如下。编号和值均为说明风险的例子,不是实测输出:
- heading "网络基础(精装版)" [ref=e7]
- StaticText "库存:3 本"
- button "购买" [ref=e8]
过滤后即使标题和购买按钮都留下了,库存文字仍可能消失。按钮可以定位,只说明存在一个动作目标,不能据此回答“有货”。裁剪策略至少要保住当前任务需要的三类信息:
- 动作目标与上下文:输入框、按钮、关联标签及所属区域,避免同名控件之间失去区分。
- 业务对象身份:书名、版本、规格及结果行的对应关系,避免把其他对象的库存接到当前对象上。
- 结果与约束证据:库存、价格、加载状态、禁用或选中状态、错误提示及失败原因。保留哪些字段由任务决定,不要求每次把全部页面都读进来。
DOM 节点引用也不能替代第二类信息:列表可能复用同一个节点展示另一条记录。引用仍可解析时,业务对象仍需重新核对。
信息不足就展开,验证后再结束
对于这个示意书店,可以先读操作目标,再读取结果区域。以下假设已经确认结果容器的真实选择器是 #results:
agent-browser snapshot -i
# 填写、查询后重新观察;读取结果时不带 -i
agent-browser snapshot -s "#results" -c
# 若还缺证据,取消紧凑过滤或扩大范围
agent-browser snapshot -s "#results"
观察仍不完整时,再读取已确认的结果节点文本,或结合截图检查图标、遮挡与布局。任务相关性选择和扩大观察的决策属于上层执行循环,不能假定 agent-browser 会自动理解库存验收标准。
还要分别衡量采集成本与模型输入成本:本文固定实现读取 getFullAXTree 后再组织输出。-i/-c/-d 让快照变短,不代表浏览器采集成本同比下降。评价观察裁剪,应同时检查目标控件能否找到、业务证据是否完整、任务是否正确完成,再比较 token 和延迟。
@ref 绑定页面元素,业务身份仍需核对
引用省去了为每一步重新编写 selector 的工作,但它不是商品 ID、订单号,也不是跨页面永久有效的地址。
当前官方文档的规则是:仍然存在的 DOM 元素可以在后续快照和同一文档更新中保留引用;页面或 iframe 导航、元素替换会影响引用有效性。没有对应 DOM 节点的虚拟无障碍节点,其引用只适用于当前快照。导航之后必须重新读取快照,交互之后也应重新观察页面变化。引用生命周期
因此,稳定的节点引用也不能独立证明业务对象没变。列表可能复用同一个 DOM 容器展示另一条记录;“购买”按钮可能仍然存在,但页面当前商品已经不同。执行涉及具体对象的动作之前,还需要核对书名、商品规格、订单号等任务条件。
| 当前变化 | 执行循环应检查什么 |
|---|---|
| 搜索后进入结果页 | 重新 snapshot,读取结果页中的控件和内容 |
| 同一页面更新库存 | 重新观察库存值,不按旧观察回答 |
| 列表重排或复用节点 | 核对该控件所属的业务记录,不能只看引用是否仍可解析 |
| 出现多个同名按钮 | 补充行、区域或业务字段以消歧;无法确认时停止操作 |
重新观察的目的包括获取可用引用,也包括更新决策证据。即使 @e1 仍然有效,页面条件也可能已经不允许继续执行原计划。
第二幕:点击之后,验证用户要的结果
(此版本省略该配图。)
查询触发后,下一步通常是读取结果。这里有一个实际影响验收的过滤条件:snapshot -i 偏向可引用的操作目标,“有货”这样的普通结果文字可能被排除;某些标题和表格单元格能够留下,也不保证所需字段完整。找动作目标时可以压缩观察,检查业务结果时则需要保留相关正文、状态或表格内容,不能把“交互快照里没出现”理解为“页面没有”。
漫画中重新读取完整快照,假设结果标题(heading)包含“网络基础:有货”,并获得引用 @e7,才继续读取它的文本。普通文本并不保证获得独立引用,实际使用时要依据快照中暴露的结果标题、区域或表格单元格定位内容:
agent-browser snapshot
agent-browser get text @e7
上层循环还需要把读取结果与任务对照:书名是否正确,是否区分版本,库存是否对应当前地区,结果是否已经加载完成。对于这个简化任务,“书名匹配且库存明确”可以构成完成条件;真实书店若按门店、配送地区或规格区分库存,就必须补齐这些条件。
截图提供另一类证据。screenshot --annotate 会在交互元素上叠加编号,编号 [N] 对应引用 @eN,用于结合视觉画面判断目标。带标注的截图
agent-browser screenshot --annotate page.png
截图能帮助判断图标、布局和视觉遮挡;是否将它作为模型输入、怎样结合语义结果,仍由调用方决定。给一个查询结果截了图,也不代表系统已经完成业务核验。
动作失败时同样需要观察。弹窗遮住按钮,应先确认弹窗内容并按任务允许的方式处理,再重新读取页面。若请求超时而动作效果未知,应先检查页面是否已经发生变化。尤其是提交、支付、删除等操作,不能仅凭未收到成功响应就重复执行。官方命令与超时说明
第三幕:Rust CLI、daemon 和 CDP 怎样分工
(此版本省略该配图。)
当前上游采用 client-daemon 架构。Rust CLI 解析命令并与 Rust daemon 通信,daemon 直接使用 CDP 驱动默认 Chrome 路径。后台在首次命令时自动启动,并在命令之间延续,避免把每条命令都处理成一次全新的浏览器任务。原生 daemon 运行时不需要 Node.js 或 Playwright;这句话描述的是当前实现,不代表所有基于 agent-browser 的历史封装也移除了这些依赖。官方架构说明
| 参与者 | 在这次查询中负责什么 | 单靠它不能证明什么 |
|---|---|---|
| 上层 Agent / 执行循环 | 理解查库存的目标、选择动作、组织恢复与验收 | 计划正确不代表页面已经执行成功 |
| Rust CLI | 将 open、snapshot、fill、click 等命令交给后台 | 命令格式有效不代表业务目标正确 |
| Rust daemon | 维护浏览器控制状态,组织观察与动作执行 | 浏览器动作成功不代表库存核对完成 |
| CDP 与 Chrome | 暴露浏览器控制能力,实际运行页面并处理交互 | 页面显示一条结果不代表符合所有业务条件 |
CDP 是 Chrome DevTools Protocol,即浏览器暴露的调试与控制协议。本文用它解释默认路径;不能据此推导所有浏览器后端都使用相同协议。
还要区分新旧实现。本站只用 Accessibility Tree,浏览器 Agent 能走多远?核验的是 @mastra/agent-browser 0.4.1 与 agent-browser 0.19.0 的组合,那条路径通过 Playwright ariaSnapshot() 生成工具快照。本文核验的上游 0.41.1 Chrome 原生路径直接读取 CDP AX Tree。工具名和命令相似,不能代替对依赖版本及真实调用链的检查。
会话延续、状态恢复与账号隔离要分别判断
漫画最后让任务收尾,是因为完成目标之后还要处理浏览器资源。同一会话可以延续此前的页面状态;使用命名会话时,后续操作也要保持相同的会话标识。
agent-browser --session books open https://example.com
agent-browser --session books snapshot
agent-browser --session books close
这组命令可以用于观察一个真实公开页面的会话操作,但不包含漫画中的库存查询逻辑。安装与浏览器准备应先按官方安装文档完成。
会话仍在运行、浏览器关闭后能恢复状态、两个账号完全隔离,是三个不同要求。官方说明,各会话分别启动浏览器时拥有独立状态;多个会话通过 --cdp 连接同一个 Chrome 时,不能仅靠不同会话名推断 Cookie 等状态完全隔离。跨次恢复则需要按实际需求配置 profile、保存状态或恢复机制。会话与隔离边界
接入多任务系统前,应先决定浏览器归谁管理、任务绑定哪个 tab、完成和异常时怎样释放,以及下次启动允许恢复哪些状态。复用一个有登录态的浏览器很方便,也意味着调用方需要了解它当前关联的账号与数据范围。
接入前,用四种变化检查执行循环
漫画展示的是简化任务。把它迁移到真实页面之前,可以用下面四类变化检查系统有没有保留足够的证据。这是建议的验收方法,不是本次已经完成的测试结果。
| 给页面增加的变化 | 应观察到的处理 | 暴露的问题 |
|---|---|---|
| 两条结果都带“查看”按钮 | 先结合书名或所在行消歧,再操作目标记录 | 模型是否把同名控件当成同一对象 |
| 查询后替换整块结果区域 | 重新读取页面,使用当前观察中的引用 | 执行循环是否沿用失效证据 |
| 弹窗挡住搜索按钮 | 识别阻挡原因,处理后再观察 | 是否把失败当成重复点击的理由 |
| 点击成功,但库存仍在加载 | 等待明确结果或返回受阻状态 | 是否把动作成功当成任务成功 |
这些检查比单独记录“能不能点到按钮”更接近 Browser Agent 的任务质量。后续若比较速度、token 或费用,还需要固定任务、页面状态和完成条件,并将失败与恢复过程计入;本文没有进行这样的性能对照,不据此给出降本或提速比例。
我的判断框架
agent-browser 适合为已经具备命令调用能力的 Agent 提供统一的网页观察与操作接口。评估接入价值时,我会先看三项条件:页面语义是否足够表达目标,引用与页面状态能否持续对应,以及结果是否有可检查的完成标准。
如果任务需要根据页面实时变化选择下一步,这些接口能提供执行循环所需的基础。若流程长期固定、定位条件清晰、主要目标是回归测试,也可以继续使用现有自动化测试工具,不必为了引入 Agent 而改写成熟流程。
接入后的验收重点应落在具体对象和完成条件上:选中的是哪一本书,读到的是哪个地区的库存,失败后有没有重复产生副作用,以及任务结束后浏览器资源是否按约定处理。工具提供了观察与动作,可靠的任务交付需要把这些证据组织起来。
资料与核验范围
本文是基于官方文档与固定源码版本的机制解析,漫画为原创教学插画。未宣称执行真实书店查询,也不构成任何具体产品已经接入该上游版本的证明。
本文使用 writting-skill 辅助写作,配图使用 better-imagegen 生成。项目已开源,欢迎在 GitHub 点个 Star。