ReAct:推理与行动的论文阅读笔记
俊宁 · 日期未详查看官网迁移清单
ReAct:在语言模型中协同推理和行动
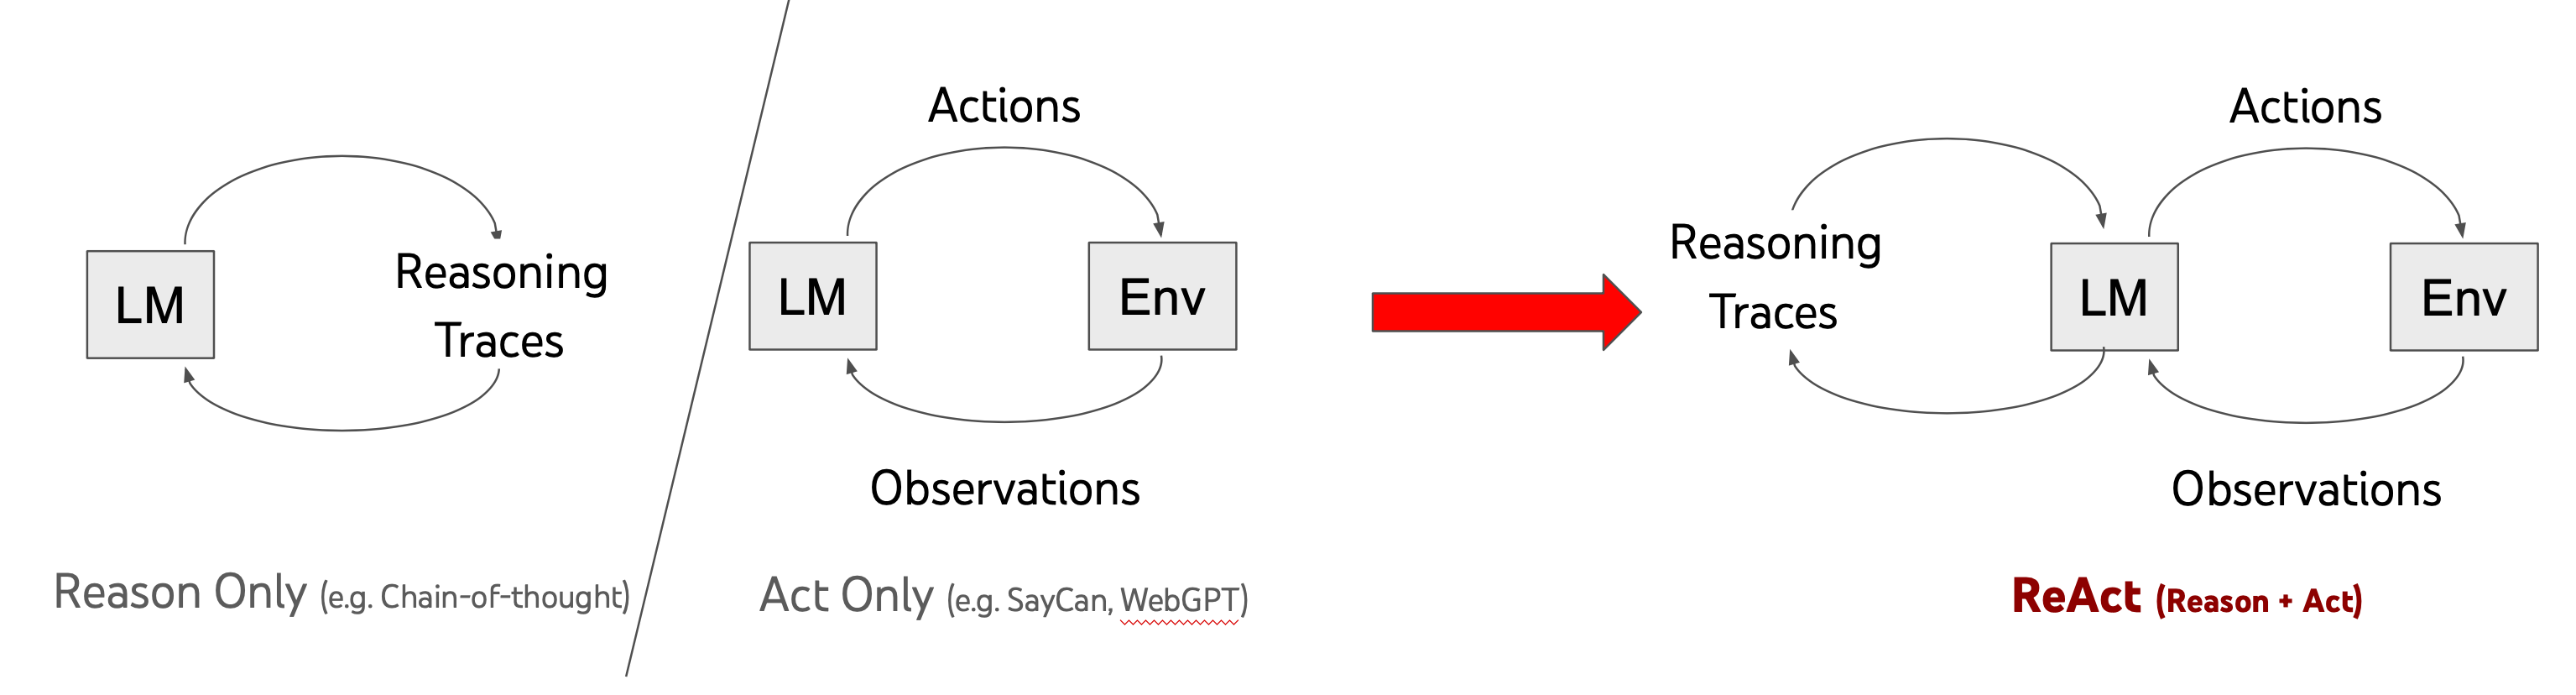
语言模型在推理(例如思维链提示)和行动(例如 WebGPT、SayCan、ACT-1)方面越来越好,但这两个方向一直保持独立。
ReAct 提出,如果将这两个基本能力结合起来会怎样?
抽象
尽管大型语言模型(LLMs)在语言理解和交互式决策任务中展现出令人印象深刻的性能,但它们在推理(例如思维链提示)和行动(例如行动计划生成)方面的能力主要被作为独立主题进行研究。在本文中,我们探讨了使用 LLMs 以交错方式生成推理轨迹和特定任务的行动,从而在两者之间实现更大的协同效应:推理轨迹帮助模型诱导、跟踪和更新行动计划,以及处理异常,而行动则允许它与外部来源(如知识库或环境)交互,以收集更多信息。我们将我们的方法(命名为 ReAct)应用于各种语言和决策任务,并证明了其在最先进基线上的有效性,以及相对于没有推理或行动组件的方法,在人类可解释性和可靠性方面的改进。 具体来说,在问答(HotpotQA)和事实核查(Fever)方面,ReAct 通过与简单的维基百科 API 交互,克服了思维链推理中普遍存在的幻觉和错误传播问题,并生成比没有推理轨迹的基线更可解释的人类任务解决轨迹。在两个交互式决策基准(ALFWorld 和 WebShop)上,ReAct 通过仅提供一到两个上下文示例,分别以 34% 和 10% 的绝对成功率超过了模仿和强化学习方法。
ReAct 提示
ReAct 提示由少量任务解决轨迹组成,包括人类编写的文本推理轨迹和动作,以及对动作的响应环境观察。
ReAct 提示直观且易于设计,在各种任务上实现了最先进的少量样本性能,从问答到在线购物!
| 提示方法 | HotpotQA (问题回答,精确匹配,6-shot) | FEVER (事实验证,精确度,3-shot) | ALFWorld (基于文本的游戏,成功率,2-shot) | WebShop (网页交互,成功率,1-shot) |
|---|---|---|---|---|
| 标准输入输出 | 28.7(准确率) | 57.1 | 无法执行 | 无法执行 |
| 仅推理 基于思维链(Chain of Thought,CoT) | 29.4 | 56.3 | 无法执行 | 无法执行 |
| 仅行动 | 25.7 | 58.9 | 45 | 30.1 |
| 最佳 ReAct 方法 | 35.1 | 64.6 | 71 | 40 |
| 监督/模仿学习 当前最优技术 | 67.5(140K 样本) | 89.5(90K 样本) | 37(100K 样本) | 29.1(90K 样本) |
总体来看,不同提示方法在各个任务上表现差异明显,监督/模仿学习这个当前最优技术在足够样本的情况下在多数任务中表现最佳,而最佳 ReAct 方法在无大量样本的情况下在多个任务中表现突出。
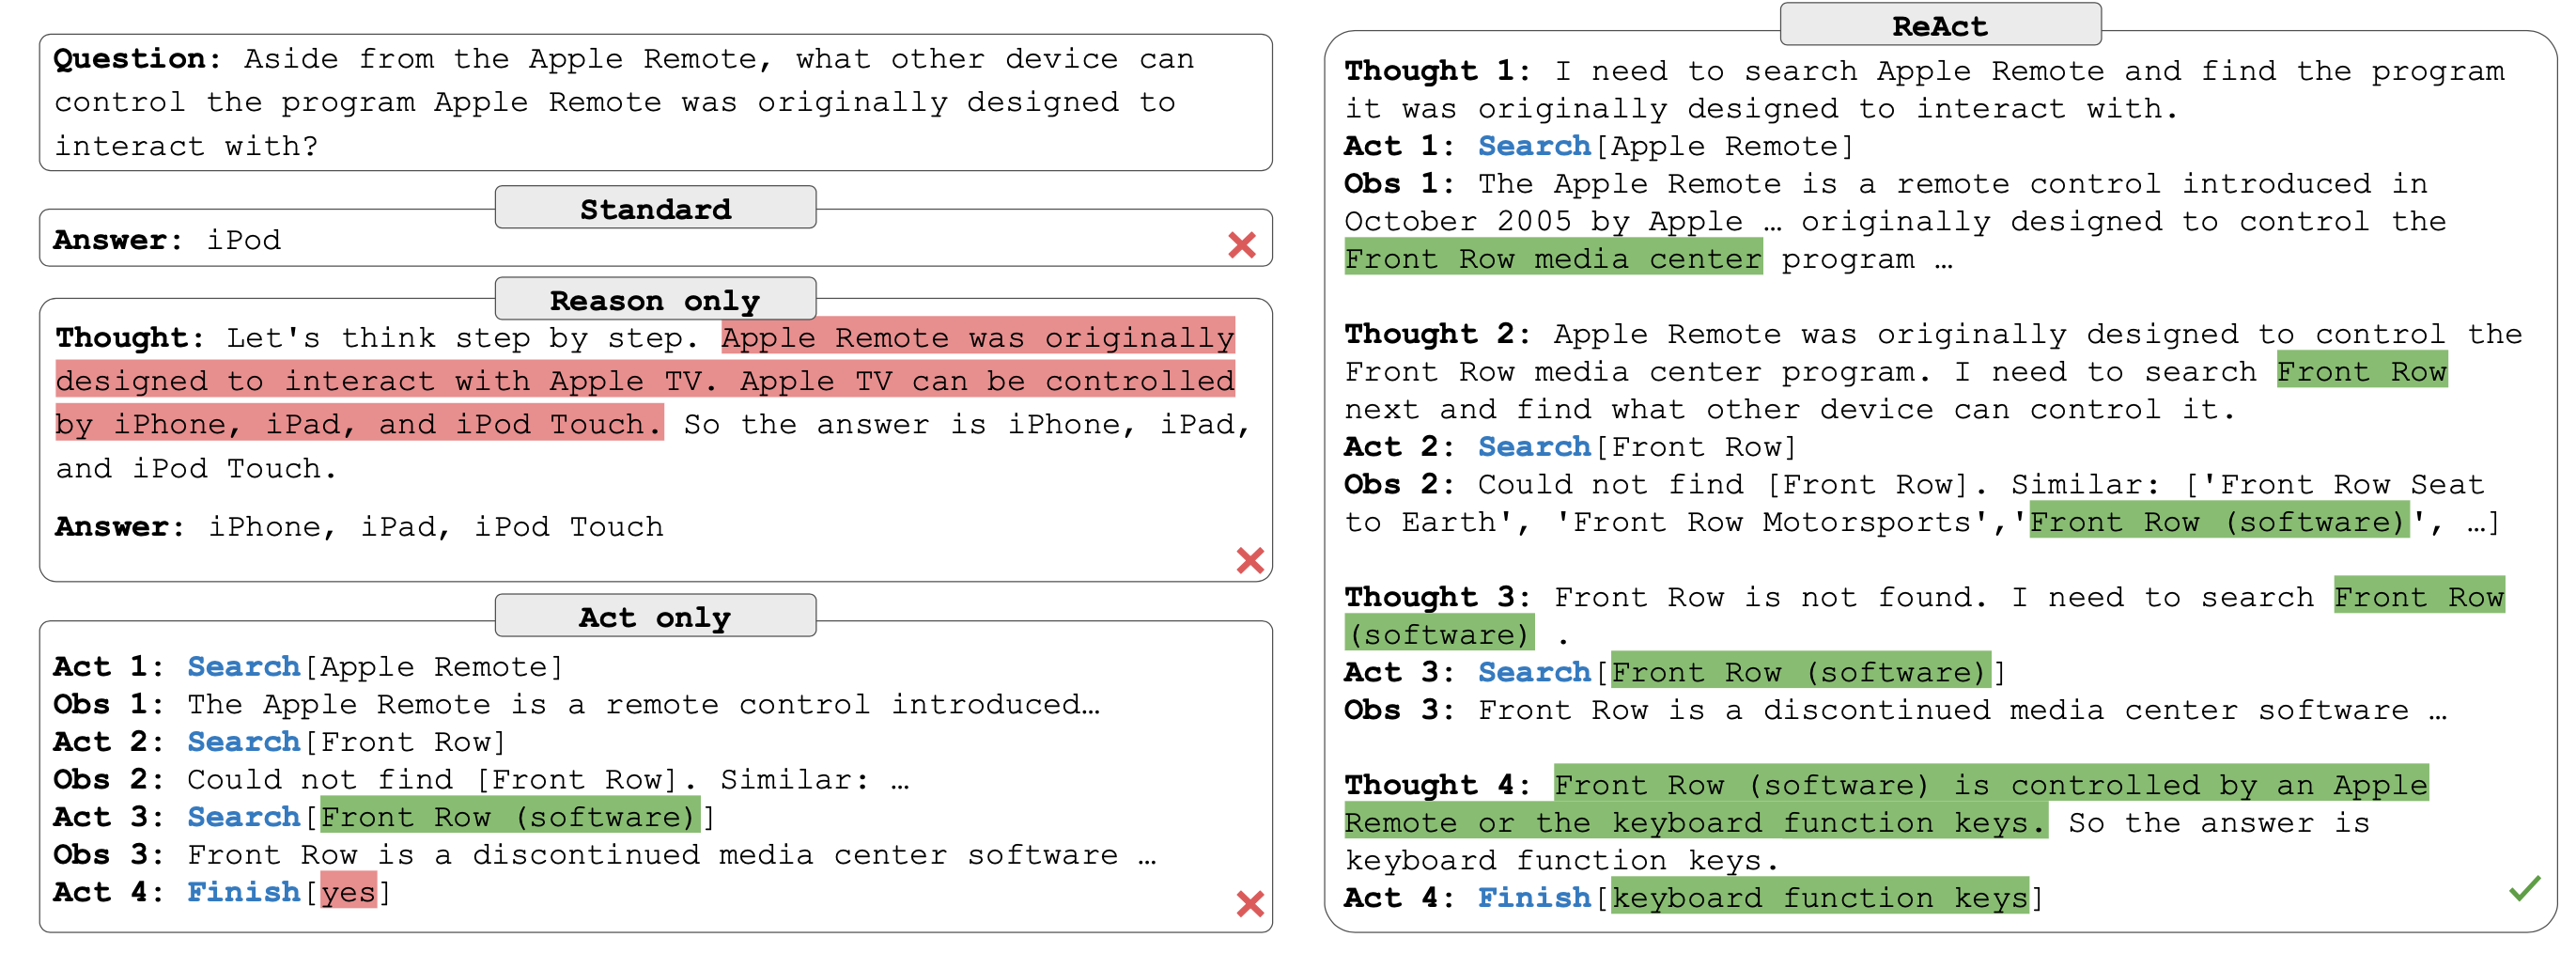
HotpotQA 示例
仅基于推理的基线(即思维链)存在错误信息(红色标注),因为它没有与外部环境结合以获取和更新支持,只能依赖有限的外部知识。
仅基于行动的基线缺乏推理能力,尽管在这个案例中具有与 ReAct 相同的行动和观察,却无法综合得出最终答案。
相比之下,ReAct 以可解释和事实性的轨迹解决了这个任务。
ALFWorld 示例
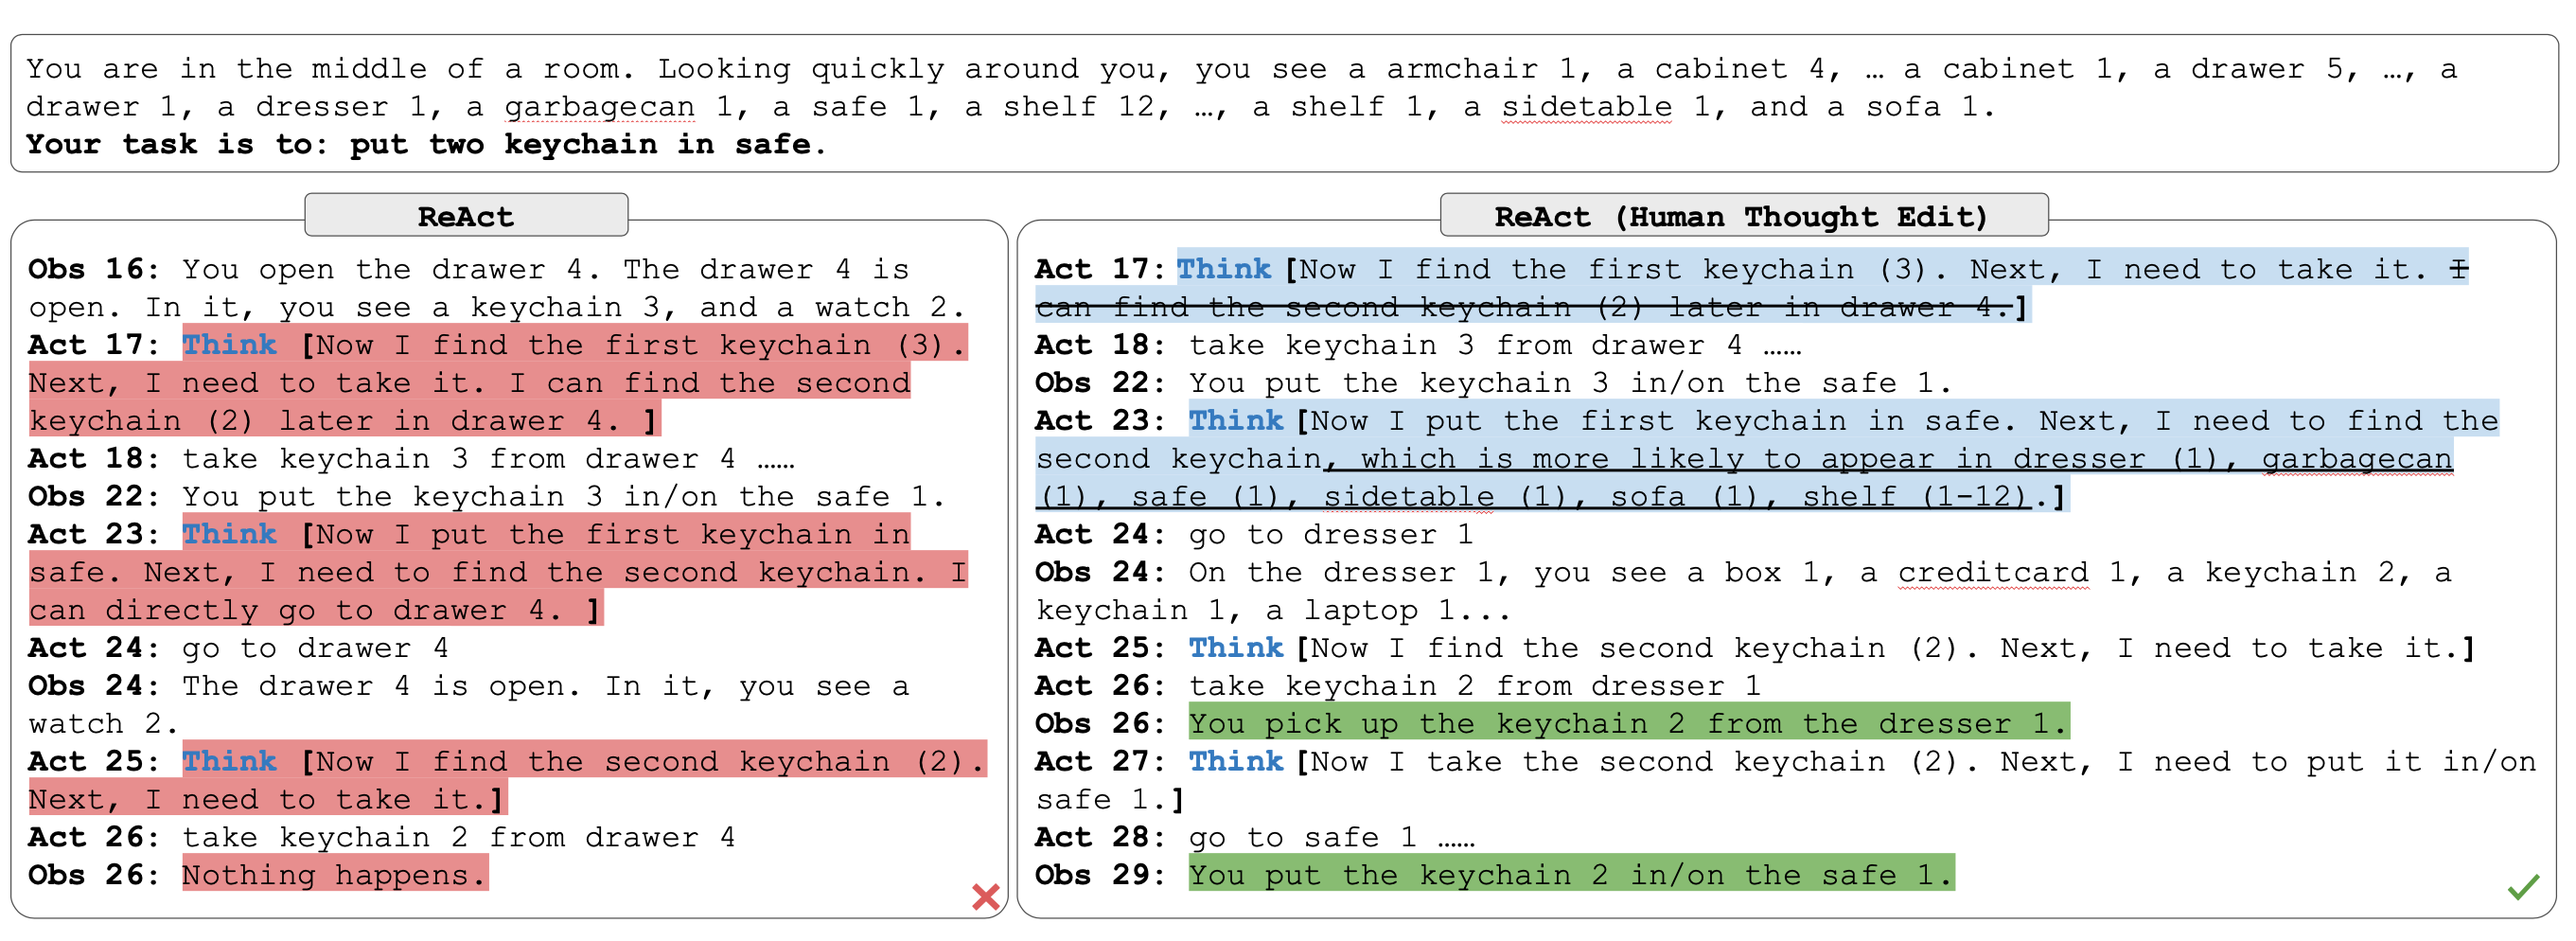
对于决策任务,我们设计具有稀疏推理轨迹的人类轨迹,让语言模型决定何时思考何时行动。
ReAct 并不完美——以下是在 ALFWorld 上的一个失败示例。然而,ReAct 格式允许通过更改几个模型思考来轻松进行人类检查和行为纠正,这是一种令人兴奋的新颖的人机对齐方法!
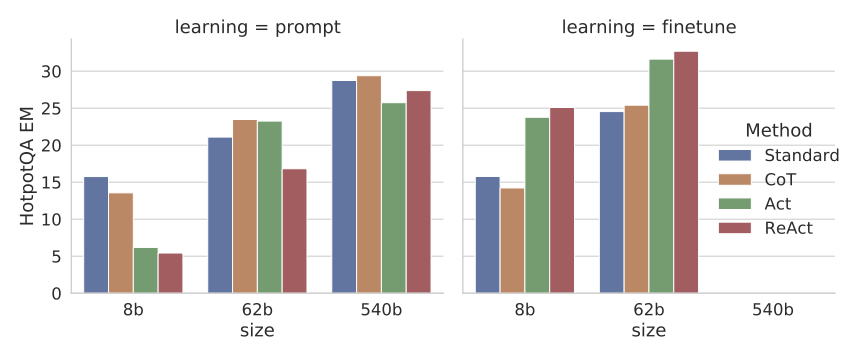
ReAct 微调:初步结果
提示词具有有限的上下文窗口和学习支持。在 HotpotQA 上使用 ReAct 提示轨迹进行初始微调的结果表明:
- ReAct 是跨模型尺寸的最佳微调格式;
- ReAct 微调的小型模型优于提示的大型模型!
ReAct: Synergizing Reasoning and Acting in Language Models
单词&短语
- synergizing [ˈsɪnərˌdʒaɪzɪŋ]:v. 协同
- reasoning [ˈriːzənɪŋ]:n. 推理
- Language Models [ˈlæŋɡwɪdʒ ˈmɑːdlz]:phr. 语言模型
- traces [ˈtreɪsɪz]:n. 轨迹
- State-of-The-Art(SoTA):当前最优技术;尖端技术、先进技术,技术发展现状
技术发展现状(state of the art)有时也称为尖端科技(cutting edge)或先进科技,是指特定时刻下,设备、技术或科学领域发展的最高层次。
- trajectories [trəˈdʒektərɪz]:n. 轨迹